Políticas de acceso IA para equipos de ingeniería
Diseña políticas de acceso para IA que funcionen: cuatro elementos esenciales para trazabilidad y seguridad, con identidades no humanas y registros.
Implemente identidades no humanas para cada agente, credenciales de corta duración por tarea, y un modelo híbrido de autorización: RBAC como límite exterior y ABAC evaluado en tiempo de ejecución. Registre en cada log qué regla concreta autorizó la acción. Sin esos cuatro elementos, cualquier política de acceso IA que diseñe será cosmética, no operativa.
En resumen:
- La implementación efectiva de políticas de acceso IA requiere identidades no humanas para cada agente, credenciales de corta duración y evaluación en tiempo real de reglas contextualizadas.
- La estrategia híbrida combina RBAC para límites categóricos y ABAC para decisiones basadas en atributos en cada llamada, conforme evolucionan las necesidades del equipo.
- Limitar la superficie de operación mediante herramientas atómicas y vincular tokens a recursos específicos reduce significativamente los riesgos de permisos excesivos y accesos no autorizados.
- Las políticas deben mantenerse como código versionado, con pruebas automatizadas y registros que permitan rastrear en qué momento y por qué se autorizó cada acción.
- La revisión continua y automatizada de permisos, junto con identidades independientes y tokens no renovables, es clave para una gestión segura y efectiva en entornos de agentes de IA.
Tabla de contenidos
- Componentes obligatorios de una política de acceso IA para agentes
- RBAC frente a ABAC: la estrategia híbrida que funciona
- Herramientas estrechas: cómo limitar lo que un agente puede hacer
- El modelo de cuatro capas: dónde ocurre la autorización real
- Política como código, pruebas en CI y auditoría trazable
- Checklist de despliegue: de auditoría inicial a madurez operativa
- Privilegio mínimo aplicado a agentes: no es lo mismo que en humanos
- Privacidad y protección de datos en el diseño de políticas de acceso
- Cómo responder cuando un agente accede sin autorización
- Integrar agentes con la identidad corporativa existente
- No todos los agentes necesitan el mismo nivel de acceso
- Por qué las políticas de acceso deben revisarse constantemente
- Por qué la mayoría de equipos automatiza antes de gobernar
- agent-swarm.dev: identidades de agente y control de herramientas listos para usar
- Fuentes
- Preguntas frecuentes
Componentes obligatorios de una política de acceso IA para agentes
Antes de escribir una sola regla de autorización, hay que resolver el problema de identidad. Un agente que actúa con el token de un humano o con una clave compartida entre diez procesos no tiene trazabilidad real: cuando algo falla, no se sabe qué instancia hizo qué.
La práctica correcta trata a cada agente como una identidad no humana (NHI) propia, con su nombre, sus metadatos y su ciclo de vida independiente. Auth0 sostiene que los agentes necesitan un modelo de permisos distinto al humano: si una credencial vinculada a una tarea concreta se filtra, su daño queda limitado al tiempo de vida corto de ese token, no a la sesión completa de un usuario.
Los elementos no negociables de esta capa son:
- Identidad propia por agente: nombre, metadata de propósito y owner, no una cuenta de servicio genérica compartida entre tareas.
- Provisión y revocación automatizadas: nada de credenciales creadas a mano que nadie recuerda desactivar.
- Token vaulting: los secretos viven en un almacén cifrado, nunca incrustados en el contexto o la ventana de conversación del agente.
- Tokens por tarea, no renovables: cada ejecución recibe su propio token con alcance mínimo y expiración corta, sin refresh automático.
Esta última regla es la que más cuesta interiorizar a equipos que vienen de arquitecturas humanas. Un agente no necesita una sesión persistente de ocho horas: necesita el permiso exacto durante los segundos que dura su tarea.
RBAC frente a ABAC: la estrategia híbrida que funciona
RBAC responde bien a una pregunta: ¿qué sistemas puede tocar este tipo de agente, en general? ABAC responde a otra, más fina: ¿debería este agente concreto, con estos atributos, ejecutar esta operación concreta, sobre este recurso, en este momento?
La comparación de Agentic Ready entre RBAC y ABAC para agentes concluye que RBAC funciona como límite exterior, mientras que las decisiones que dependen de contexto exigen ABAC evaluado en cada llamada. La estrategia pragmática no es elegir uno: es empezar con RBAC porque se integra con el IAM corporativo existente, y añadir ABAC en la capa de llamada a herramientas en cuanto aparezcan reglas condicionadas por transacción, clasificación de datos o riesgo relevante.
| Dimensión | RBAC | ABAC |
|---|---|---|
| Qué resuelve | Límites categóricos por tipo de agente | Decisiones por operación según contexto |
| Cuándo se evalúa | Al asignar el rol | En cada llamada a herramienta |
| Ejemplo de regla | «Los agentes de soporte solo acceden a tickets» | «Solo transferencias bajo cierta cantidad sin aprobación humana» |
| Coste operativo | Bajo, fácil de auditar | Mayor, requiere motor de políticas |
| Herramientas típicas | IAM existente, grupos de rol | Open Policy Agent (OPA), Cedar |
La señal para dar el salto a ABAC suele ser la misma en todos los equipos: cuando empiezan a crear roles nuevos solo para cubrir un caso de contexto puntual, es que necesitan atributos, no más roles. Motores como OPA o Cedar permiten expresar esas reglas como código y generar un registro de decisión (decision log) por cada evaluación, algo que un simple mapa de roles nunca ofrece.
Herramientas estrechas: cómo limitar lo que un agente puede hacer
La superficie de autorización más peligrosa no es la política mal escrita: es la herramienta demasiado amplia. Un agente con una función "editar_base_de_datos" tiene, de facto, más poder que cualquier política pueda contener después.
Diseñar herramientas atómicas, con permisos de lectura por defecto y escritura como excepción explícita, reduce ese riesgo desde el origen. El estándar de Model Context Protocol junto con el mecanismo de indicadores de recurso de RFC 8707 permite vincular un token al servicio concreto de destino, así ese token no sirve para nada fuera de esa herramienta específica aunque sea interceptado.
Prácticas que conviene aplicar sin excepción:
- Definir operaciones atómicas y estrechas en vez de funciones genéricas de "hacer cualquier cosa" sobre un sistema.
- Vincular cada token al recurso o servicio destino, nunca a un ámbito amplio reutilizable.
- Evitar que el orquestador actúe como proxy privilegiado que reenvía credenciales en nombre del agente.
- Exigir aprobación humana explícita para cualquier escritura crítica o irreversible.
Este último punto suele generar resistencia porque ralentiza el flujo. Pero un agente que puede borrar registros de producción sin un humano de por medio no está "automatizado": está desatendido.
El modelo de cuatro capas: dónde ocurre la autorización real
Conviene pensar el control de acceso como un mapa de cuatro capas, no como un único punto de decisión.
- Autenticación (adapter): establece quién es el actor, sea usuario, agente o servicio, antes de cualquier otra evaluación.
- Exposición (discovery): decide qué capacidades y herramientas se muestran al agente en su catálogo disponible.
- Políticas: aplica las reglas específicas por tipo de agente, RBAC y ABAC combinados, sobre lo que ya fue expuesto.
- Middleware o handler: ejecuta el chequeo autoritativo final, verificando tenencia (tenancy) y permisos reales antes de tocar el recurso.
El repositorio de oRPC Agent describe este modelo de cuatro capas y es explícito en un punto que muchos equipos pasan por alto: filtrar herramientas en la capa de discovery mejora la experiencia del agente, pero nunca sustituye la verificación en el middleware. Filtrar en discovery evita ruido; hacer cumplir en ejecución evita brechas.
Consejo profesional: si su plataforma solo filtra en la capa de discovery y confía en que el agente "no verá" la herramienta prohibida, tiene una vulnerabilidad, no una política. Un prompt malicioso o una respuesta manipulada puede invocar directamente esa herramienta si el middleware no repite el chequeo.
Política como código, pruebas en CI y auditoría trazable
Una política de acceso IA que vive en un documento de Confluence no es una política: es una intención. Las reglas deben estar en control de versiones, revisables por pull request como cualquier cambio de código.
WorkOS recomienda gestionar la autorización como policy-as-code con OPA o Cedar, precisamente porque eso permite pruebas automatizadas y evita el drift de configuración que aparece cuando cada equipo ajusta reglas a mano en producción.
La disciplina mínima incluye:
- Almacenar las políticas en el mismo repositorio de infraestructura, con revisión obligatoria antes de fusionar cambios.
- Escribir tests que cubran casos límite y patrones anómalos, no solo el camino feliz.
- Integrar esos tests en el pipeline de CI/CD, de modo que una política rota nunca llegue a producción.
- Generar registros de decisión que incluyan el identificador exacto de la regla que autorizó cada acción, no solo un «permitido» o «denegado» genérico.
Esa trazabilidad es lo que separa una auditoría de una investigación forense de semanas. Establecer una cadencia de revisión trimestral, con detección automática de drift entre lo declarado y lo aplicado, evita que las políticas se queden obsoletas frente a nuevas integraciones o agentes.
Checklist de despliegue: de auditoría inicial a madurez operativa
Pasar de un entorno sin control a uno gobernado no ocurre en un solo sprint. Un análisis reciente sobre por qué RBAC no basta para agentes de IA propone empezar por lo urgente y avanzar hacia lo estructural.
- Auditoría inicial: mapee todos los alcances (scopes) activos hoy y marque las herramientas de mayor riesgo, especialmente las de escritura o borrado.
- Mitigación inmediata: rote credenciales expuestas, recorte alcances sobredimensionados y convierta las herramientas peligrosas en operaciones estrechas y auditables.
- Separación de identidad: emita identidades no humanas independientes para cada agente, eliminando cuentas de servicio compartidas.
- Credenciales por tarea: migre hacia tokens de vida limitada y no renovables, alineados a cada ejecución concreta.
- ABAC progresivo: añada evaluación por atributos en las operaciones que lo requieran, sin abandonar el RBAC de base.
Como indicadores de progreso, siga el tiempo medio de revocación de una credencial comprometida, el número de alcances activos por agente y la cantidad de hallazgos de drift detectados entre auditorías. Una reducción sostenida de estos tres números es la señal más fiable de que el programa está maduro, más fiable que cualquier informe de cumplimiento.
Privilegio mínimo aplicado a agentes: no es lo mismo que en humanos
El principio de privilegio mínimo existe desde hace décadas en seguridad informática, pero aplicarlo a agentes de IA exige una revisión distinta a la que se hace con empleados.
Un humano acumula permisos con el tiempo porque cambia de proyecto, asume nuevas responsabilidades o rota de equipo. Un agente, en cambio, ejecuta la misma clase de tarea miles de veces al día: si su alcance es demasiado amplio, el error se replica a esa misma escala. Por eso el privilegio mínimo en agentes no se mide por rol organizativo, sino por operación atómica: qué necesita realmente esta llamada específica para completar esta tarea específica, nada más.
La gestión de permisos mínimos, en la práctica, significa tres cosas. Primero, cada nuevo agente arranca con acceso de solo lectura hasta que se demuestre la necesidad de escritura. Segundo, cualquier ampliación de alcance pasa por el mismo proceso de revisión que un cambio de código, no por una excepción verbal. Tercero, los alcances no usados durante un periodo definido se retiran automáticamente en vez de acumularse indefinidamente.
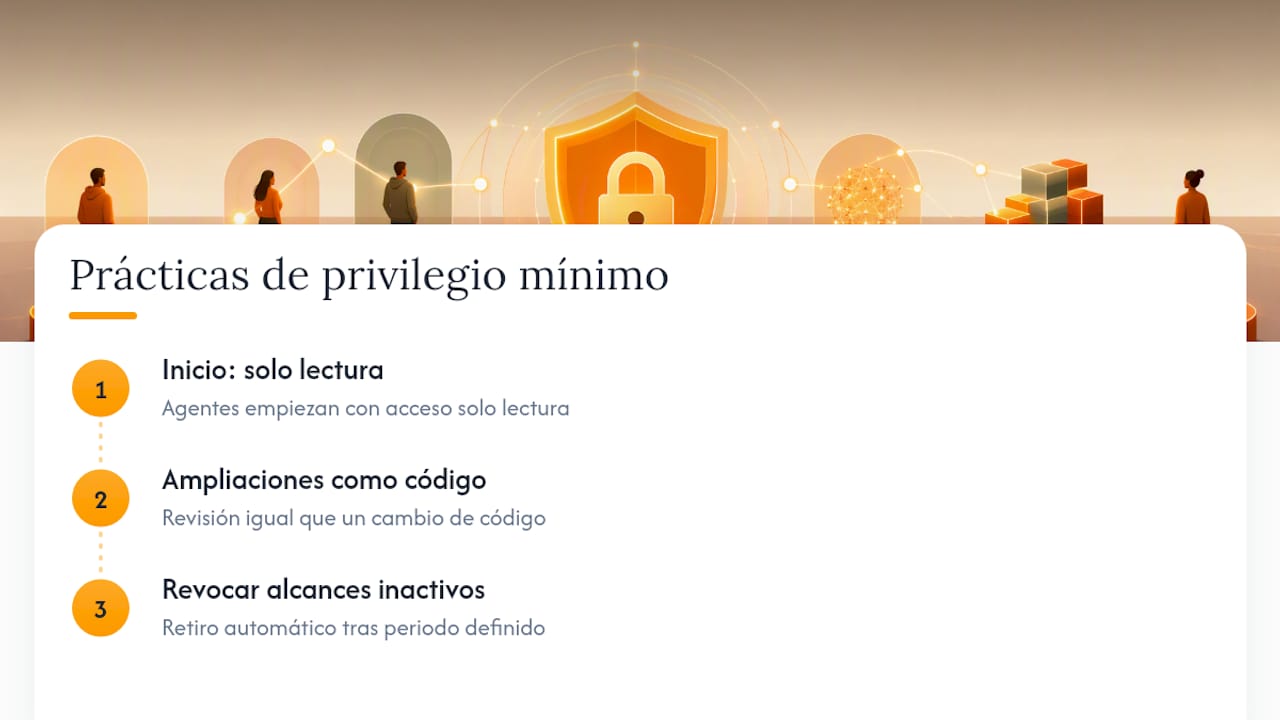
Los equipos que tratan el privilegio mínimo como una revisión puntual en el lanzamiento, en lugar de un proceso continuo, terminan con lo que en seguridad se llama «acumulación de privilegios»: agentes que en su día necesitaron un permiso concreto y todavía lo conservan meses después, sin que nadie lo haya vuelto a cuestionar. Auditar alcances activos periódicamente, no solo al desplegar, es la diferencia entre un principio de papel y uno que realmente reduce el riesgo.
Privacidad y protección de datos en el diseño de políticas de acceso
Una política de acceso IA bien diseñada no solo decide quién puede ejecutar qué acción: también decide qué datos puede ver un agente para tomar esa decisión, y durante cuánto tiempo los conserva en su contexto.
El riesgo específico de los agentes frente a los sistemas tradicionales es que su "memoria" de trabajo, la ventana de contexto, puede terminar conteniendo datos personales, credenciales o información sensible que nunca debería persistir más allá de la tarea. Una política de acceso IA sólida limita qué campos de un registro puede leer un agente, en vez de exponerle el objeto completo cuando solo necesita un campo. Aplicar minimización de datos en el diseño de cada herramienta, y no solo en el nivel de base de datos, reduce la cantidad de información sensible que circula por logs, prompts y respuestas intermedias.
Esto conecta directamente con regulaciones de privacidad como el RGPD europeo o leyes equivalentes en otras jurisdicciones: si un agente procesa datos personales, esa política de acceso debe poder demostrar, ante una auditoría, qué agente accedió a qué dato personal, con qué base legal y durante cuánto tiempo. Los registros de decisión mencionados antes cumplen aquí una doble función: sirven tanto para depuración técnica como para evidencia de cumplimiento normativo. Diseñar la política de acceso pensando en esa doble exigencia desde el principio evita reconstruir todo el sistema de logging más adelante bajo presión de un auditor.
Cómo responder cuando un agente accede sin autorización
La primera pregunta ante cualquier incidente de acceso no autorizado no es «¿qué pasó?» sino «¿qué puede tocar todavía esa credencial?». Si las credenciales por tarea y no renovables están bien implementadas, la respuesta debería ser: casi nada, porque el token ya caducó o está a punto de hacerlo.
Un plan de respuesta a incidentes centrado en agentes necesita tres capacidades que muchos equipos descubren que les faltan justo cuando las necesitan. La primera es revocación inmediata a nivel de identidad individual, no solo a nivel de servicio completo: poder apagar un agente concreto sin tumbar a los otros treinta que comparten integración. La segunda es reconstrucción de la cadena de decisión: gracias a los registros con el identificador de regla que autorizó cada acción, un equipo puede reconstruir en minutos qué política permitió el acceso indebido, en vez de revisar código durante días. La tercera es contención de alcance: si un agente comprometido solo tenía acceso a una herramienta estrecha con permisos de lectura, el radio de impacto (blast radius) queda naturalmente acotado.
Después de contener el incidente, la pregunta operativa real es por qué la política permitió esa acción en primer lugar. Cada incidente de acceso no autorizado debería generar como mínimo una regla nueva o corregida y un test en CI que evite que se repita. Sin ese cierre del ciclo, el mismo tipo de brecha volverá a aparecer con otro agente distinto seis meses después.
Integrar agentes con la identidad corporativa existente
Ningún equipo diseña sus políticas de acceso IA desde cero: casi siempre hay ya un proveedor de identidad corporativo, sea Okta, Azure AD, Google Workspace o un sistema federado propio, gestionando empleados y servicios.
La pregunta correcta no es si sustituir ese sistema, sino cómo extenderlo para que reconozca identidades no humanas sin tratarlas como cuentas de usuario disfrazadas. La mayoría de proveedores de identidad ya soportan cuentas de servicio o aplicaciones registradas: el ajuste está en aplicarles el mismo rigor de rotación y alcance limitado que a un agente diseñado específicamente para eso, en lugar de heredar los permisos amplios que suele tener una cuenta de servicio tradicional.
Federar la identidad de los agentes con el proveedor corporativo tiene una ventaja concreta: cuando un empleado sale de la empresa y su acceso se revoca centralmente, los agentes que actuaban en su nombre o bajo su contexto deben quedar igualmente inhabilitados sin intervención manual adicional. Esa dependencia cruzada hay que probarla explícitamente, porque es exactamente el tipo de caso límite que un test de política en CI debería cubrir.
El punto de fricción habitual aparece cuando el equipo de identidad no participa desde el diseño inicial de los permisos de agentes, sino que se incorpora después para "aprobar" un modelo ya construido. Involucrar a ese equipo desde la fase de definición de entitlements reduce la complejidad posterior y evita que aparezcan soluciones improvisadas fuera del sistema de identidad central, que son precisamente las que terminan generando el mayor riesgo.
No todos los agentes necesitan el mismo nivel de acceso
Tratar a un agente de soporte al cliente y a un agente de despliegue de infraestructura bajo la misma política es el error de diseño más común en plataformas de orquestación jóvenes.
Cada rol de agente implica un perfil de riesgo distinto y, por tanto, una política distinta:
- Agentes de lectura e informes (análisis, resúmenes, búsqueda): acceso de solo lectura, sin necesidad de credenciales de escritura en ningún sistema.
- Agentes de soporte y comunicación (respuesta a tickets, mensajería): acceso de escritura limitado a un sistema concreto, con aprobación humana para acciones irreversibles como reembolsos.
- Agentes de ingeniería (revisión de código, despliegue): acceso más amplio pero compartimentado por repositorio o entorno, nunca con credenciales válidas para producción y staging a la vez.
- Agentes con capacidad financiera u operativa crítica: umbrales explícitos de aprobación humana por encima de un valor definido, gestionados vía ABAC en vez de un permiso binario de todo o nada.
La tentación de crear una política única "razonable" para todos los agentes ahorra tiempo de diseño al principio, pero termina o bien bloqueando a los agentes que sí necesitan más acceso, o bien sobredimensionando a los que no lo necesitan. Ninguno de los dos resultados es aceptable en un sistema con docenas de agentes activos simultáneamente. Definir el rol antes de definir el permiso, y no al revés, es la secuencia que evita ese problema.
Por qué las políticas de acceso deben revisarse constantemente
Una política de acceso IA escrita hoy no está diseñada para las capacidades que tendrá el mismo agente en seis meses. Los modelos subyacentes mejoran, los agentes ganan nuevas herramientas y los atacantes desarrollan técnicas de manipulación que no existían cuando se definieron las reglas originales.
Esto convierte la gobernanza del acceso a IA en un proceso continuo, no en un proyecto con fecha de cierre. Los equipos maduros tratan sus políticas como código vivo: cada nueva integración de herramienta dispara una revisión, cada incidente genera un test nuevo, y cada trimestre se compara el estado real de los alcances activos contra lo que la política declara que debería existir, buscando ese drift que se acumula silenciosamente.
La evolución de amenazas específicas de agentes, como la inyección de instrucciones (prompt injection) o el escalado autónomo de privilegios sin intervención externa, exige que las pruebas de política en CI se actualicen con la misma cadencia que las pruebas de seguridad de código tradicional. Un test que cubría los vectores de ataque conocidos hace un año probablemente no cubre los que aparecieron este trimestre.
La métrica que mejor predice si un programa de gobernanza va a fallar no es cuántas políticas tiene escritas, sino cuánto tiempo pasa entre que aparece una nueva capacidad de agente y que existe una regla explícita que la gobierna. Cuanto más se acerque esa ventana a cero, más resiliente es el sistema frente a capacidades que todavía no se han imaginado.
Por qué la mayoría de equipos automatiza antes de gobernar
La secuencia natural en casi todos los equipos de ingeniería es automatizar primero y gobernar después, cuando debería ser al revés. He visto (y el patrón se repite en la literatura del sector) que los equipos despliegan agentes con credenciales amplias porque "ya se ajustará después", y ese después casi nunca llega hasta que ocurre un incidente.
Lo que de verdad reduce el riesgo operativo no es un documento de políticas extenso, sino la combinación específica de identidades no humanas, credenciales que caducan solas y registros que apuntan a la regla exacta que autorizó cada acción. Esa combinación convierte una investigación de incidente de semanas en una consulta de minutos, y eso, más que cualquier certificación, es lo que separa una plataforma de agentes lista para producción de un experimento con suerte. En Agent-swarm documentamos varios de estos patrones a partir de sesiones reales de agentes trabajando en contenedores aislados, precisamente porque la teoría de control de acceso solo convence cuando se ve fallar y recuperarse en un entorno real.
La objeción habitual es que todo este rigor ralentiza la entrega. Es cierto en la primera semana. A partir de la segunda, cuando el equipo ya no tiene que investigar manualmente por qué un agente tocó algo que no debía, la velocidad se recupera con creces.
— Ez.-
agent-swarm.dev: identidades de agente y control de herramientas listos para usar
agent-swarm es la alternativa de código abierto para equipos que necesitan aplicar estas políticas sin construir la capa de gobernanza desde cero: cada agente trabajador opera en un contenedor Docker aislado, con su propia identidad y su propio alcance de herramientas, en vez de compartir credenciales con el agente principal o entre sí.
La plataforma soporta identidades separadas por agente, integraciones nativas con Slack, Linear, GitHub, Turso y decenas de plataformas más, y control de permisos por rol para equipos de ingeniería, soporte, operaciones, ventas y marketing dentro del mismo panel. Eso significa que la separación entre RBAC exterior y control fino por tarea que describimos en las secciones anteriores no es una arquitectura que haya que ensamblar con piezas sueltas: viene incorporada en cómo el agente principal delega trabajo a los agentes especializados.
Puede autohospedar agent-swarm gratis bajo licencia MIT o probar la versión Cloud con suscripción escalable según el número de agentes activos. Antes de diseñar su primera política, revise la guía de gobernanza de agentes y los ejemplos de sesiones reales para ver estos controles en funcionamiento, y compare las opciones en la página de alternativas si todavía está decidiendo qué orquestador se ajusta a su infraestructura.
Fuentes
Para profundizar en la implementación, conviene revisar el estándar Model Context Protocol con indicadores de recurso RFC 8707, el análisis de oRPC Agent sobre el modelo de cuatro capas, la comparación práctica de RBAC frente a ABAC de Agentic Ready y el análisis técnico sobre exfiltración de credenciales vía contexto publicado por agent-swarm.
- Four-layer authorization model — oRPC Agent (repo)
Preguntas frecuentes
¿Qué son las políticas de acceso IA en un orquestador de agentes?
Son las reglas que definen qué identidad, con qué credenciales y bajo qué condiciones, puede un agente de IA ejecutar una acción concreta sobre un recurso o herramienta determinada.
¿Debo dar a cada agente su propio usuario o reutilizar cuentas de servicio?
Cada agente necesita una identidad no humana propia, con metadatos y ciclo de vida independiente. Reutilizar cuentas de servicio compartidas elimina la trazabilidad cuando algo falla.
¿Cuándo conviene pasar de RBAC a ABAC?
Cuando empieza a crear roles nuevos solo para cubrir casos de contexto puntuales, como un umbral de importe o una clasificación de datos concreta, es señal de que necesita atributos evaluados en tiempo de ejecución, no más roles.
¿Qué debe registrar un log de autorización de agentes?
Debe incluir el identificador exacto de la regla que autorizó o denegó la acción, junto con el contexto de la llamada, no solo un resultado binario de permitido o denegado.
¿agent-swarm aplica estas políticas de forma nativa?
Hay plataformas que asignan identidades separadas a cada agente trabajador en contenedores aislados y permiten control de permisos por rol, lo que facilita aplicar el modelo híbrido RBAC más ABAC descrito en esta guía sin construirlo desde cero.
Recomendaciones
Related field notes
Roles y permisos en agentes de IA: la base de un despliegue seguro
Asegura agentes de IA con roles y permisos: limita accesos, aplica mínimo privilegio, políticas como código y registro de auditoría verificable.
Ship to Production: Six n8n Alternatives for Engineering Teams
Engineering-first comparison of six production-ready n8n alternatives for stateful multi-agent orchestration. See which tools offer persistent memory,...
Tareas programadas con agentes de IA: guía práctica sin código
Programa agentes de IA sin código para ejecutar tareas autónomas según tu calendario y delega vigilancia o trabajos repetitivos con permisos e historial.