Aprobaciones de despliegue IA: la arquitectura que necesitas ya
Protege despliegues de IA con aprobación humana obligatoria, políticas declarativas, mínimo acceso y parada aislada; según OWASP AISVS.
La aprobación de despliegue IA en producción debe ser un gate humano vinculante combinado con políticas declarativas, mínimo privilegio y un kill-switch aislado, no una confianza ciega en la autonomía del agente. La referencia técnica es OWASP AISVS: nivel 1 exige parada aislada, nivel 2 exige verificación humana con TTL. Sobre eso se apoyan ValidatingAdmissionPolicy y un registro de auditoría inmutable.
En resumen:
- Solo se deben aprobar despliegues de IA con un gate humano vinculante, políticas y registros que aseguren control y trazabilidad, sin confiar ciegamente en la autonomía del agente.
- Es imprescindible clasificar la acción según su impacto, irreversibilidad, exposición normativa y confianza acumulada, para definir niveles de control específicos y evitar alertas excessivas.
- Se recomienda implementar un modelo en semanas, incluyendo clasificación de riesgo, punto de aplicación de políticas, credenciales efímeras y un kill-switch externo, priorizando acciones críticas.
- Los patrones técnicos efectivos incluyen un proxy de acciones destructivas y sandboxing por herramientas, rotación de claves criptográficas y validaciones automáticas en el clúster para evitar saltarse controles.
- La gestión de permisos, roles y registros, junto con revisiones periódicas, garantiza un control ético, legal y operacional, con registros que soporten auditorías y cumplimiento en sectores regulados.
Tabla de contenidos
- Modelo de gates y niveles de aprobación (arquitectura conceptual)
- Checklist técnico para empezar en semanas
- Patrones técnicos que evitan que el gate se salte
- Gobernanza, roles y procesos operativos
- Verificación, monitoreo y respuesta: qué medir y cómo operar
- Marcos legales y regulaciones específicas para aprobaciones de despliegue de IA
- Criterios éticos para la aprobación de despliegues de IA
- Evaluación de riesgos y análisis de impacto previo a la aprobación
- Integración con sistemas de gobernanza y cumplimiento normativo
- Procedimientos para la revisión y actualización periódica de aprobaciones
- Lecciones prácticas sobre confianza y coste operativo
- Cómo agent-swarm.dev ayuda a implementar aprobaciones de despliegue seguras
- Fuentes
- Preguntas frecuentes
Modelo de gates y niveles de aprobación (arquitectura conceptual)
Antes de escribir una sola línea de política, hay que clasificar la acción. No todas las llamadas que hace un agente merecen el mismo escrutinio, y tratarlas igual es la razón por la que la mayoría de los pipelines de aprobación colapsan bajo su propio peso: demasiadas alertas, cero atención real cuando importa.
Cuatro criterios determinan el nivel de control necesario:
- Irreversibilidad: ¿se puede deshacer la acción (rollback) o es definitiva (borrar una base de datos, enviar dinero)?
- Blast radius: ¿afecta a un contenedor aislado o a infraestructura compartida por varios equipos?
- Exposición normativa: ¿toca datos regulados, contratos o información financiera?
- Confianza acumulada: ¿cuántas veces ese agente ejecutó esa misma acción sin incidentes?
De ahí surgen tres niveles operativos. El nivel 1 es un kill-switch aislado que corta la ejecución sin depender del propio sistema que se quiere detener. El nivel 2 exige aprobación humana obligatoria con un tiempo de vida (TTL) definido, siguiendo la clasificación de OWASP. El nivel 3 añade aprobación criptográfica o esquemas N-de-M para acciones de máximo impacto, como cambios en producción crítica.
El flujo de aprobación humana previa (HITL) se resuelve en cinco pasos: el agente propone la acción con parámetros completos, el sistema calcula el nivel de riesgo, se presenta un diff canónico al aprobador, la aprobación queda vinculada criptográficamente a esos parámetros exactos y arranca un TTL que caduca la autorización si no se ejecuta a tiempo.
Consejo profesional: nunca aprueben una descripción textual de la acción. Exijan que la interfaz muestre el comando exacto, los destinatarios y las cantidades, no un resumen generado por el propio agente que se está autorizando.
Checklist técnico para empezar en semanas
No hace falta un rediseño de meses. Con seis piezas bien secuenciadas, un equipo de plataforma puede tener gates funcionando en semanas:
- Codifiquen la clasificación de riesgo como policy-as-code, no como un documento de wiki que nadie revisa.
- Desplieguen un punto de aplicación de políticas (PEP/PDP) o gateway de autorización que exija un token de aprobación antes de reenviar cualquier llamada de escritura o destructiva.
- Configuren ValidatingAdmissionPolicy con reglas CEL en el clúster para bloquear despliegues que no cumplan el esquema aprobado, antes de que el recurso se persista.
- Emitan credenciales de corta duración por tarea, con alcance limitado a esa subtarea específica, y borren el estado al terminar.
- Habiliten un kill-switch fuera de banda y pruébenlo con simulacros de revocación reales, no solo en teoría.
- Instrumenten logs de auditoría inmutables que liguen cada aprobación a sus parámetros exactos y conserven esa evidencia el tiempo que exija su marco de cumplimiento.
El orden importa: el PEP/PDP y las políticas de riesgo son la base; sin ellas, el kill-switch y los logs solo documentan el desastre después de que ocurra.
Consejo profesional: empiecen por las acciones destructivas (borrar, transferir, desplegar en producción) antes que por las de lectura. Es donde el coste de un fallo es más alto y donde ganan más credibilidad interna con el primer gate funcionando.
Patrones técnicos que evitan que el gate se salte
Un gate de aprobación solo vale si nadie puede rodearlo, y hay patrones concretos que lo garantizan a nivel de arquitectura, no de buena voluntad.
El proxy de acciones destructivas es el más simple y el más efectivo: intercepta cualquier llamada marcada como sensible, la retiene, y exige un token de aprobación válido antes de reenviarla al destino real. El agente nunca tiene la capacidad técnica de ejecutar directamente; solo puede proponer.
El sandboxing por herramienta limita el radio de explosión desde el diseño. Cada herramienta corre con su propio manifiesto: listas de salida permitidas (egress allowlists), límites de CPU y memoria, y permisos que no se heredan entre tareas. MITRE ATLAS recomienda además una identidad criptográfica única por agente, con rotación periódica de claves, para que cada acción quede firmada y sea imposible de repudiar.
Tratar a los agentes de IA como ciudadanos de primera clase en la gestión de identidades, con rotación de claves y tokens efímeros por tarea, reduce directamente el radio de explosión de cualquier fallo o compromiso.
En integración con CI/CD, las reglas de protección de despliegue de GitHub Actions muestran el patrón de referencia: revisores obligatorios, temporizadores de espera y aplicaciones personalizadas de protección que pueden condicionar cualquier promoción a producción.
- El PEP/PDP debe emitir credenciales efímeras y firmar cada aprobación para trazabilidad no repudiable.
- Las validaciones declarativas con ValidatingAdmissionPolicy se ejecutan en el propio clúster, sin depender de un webhook externo que puede caerse justo cuando más se necesita.
- Los secretos de despliegue deben rotar automáticamente tras cada aprobación de nivel 3, no quedar vivos indefinidamente.
Gobernanza, roles y procesos operativos
Sin roles claros, cualquier gate técnico se degrada en una casilla de verificación vacía. Cuatro papeles deberían estar siempre separados:
- Autor: propone el cambio o la acción del agente.
- Revisor técnico: valida la corrección del código o de la configuración.
- Aprobador de negocio o MPA: autoriza el impacto operativo o regulatorio, siguiendo el principio de autorización multiparte de Google SRE.
- Auditor: revisa después, sin poder haber participado en la aprobación original.
La regla que no admite excepciones es la ausencia de autoaprobación: nadie autoriza su propio cambio, ni siquiera bajo presión de plazos. Para elevaciones puntuales, el acceso "a demanda" (AoD) concede permisos temporales con justificación registrada, y ese acceso se cierra solo, sin intervención manual.
Google SRE llama a esto controles NoPe ("no persons"): eliminar el acceso humano directo a producción y sustituirlo por elevaciones temporales, justificadas y auditadas, reduciendo el acceso unilateral a un mínimo verificable. Para cambios de bajo riesgo, la revisión por pares y las pruebas automatizadas bastan; el escalado a un comité formal solo se justifica para acciones de alto impacto. El informe DORA 2024 recomienda medir estos procesos con objetivos de nivel de servicio (SLO) explícitos, para que la conversación entre velocidad y estabilidad se base en datos y no en intuición.
Verificación, monitoreo y respuesta: qué medir y cómo operar
Un sistema de aprobaciones que nadie verifica es una promesa, no un control. La base es un registro inmutable y firmado que liga cada aprobación a sus parámetros exactos y a la ejecución que provocó, de modo que cualquier auditoría posterior pueda reconstruir la cadena completa sin depender de la memoria de nadie.
Sobre esa base hay que vigilar el drift: patrones de invocación entre agentes que se desvían de la línea base histórica suelen preceder a un incidente, no seguirlo. Los simulacros regulares (pruebas de bypass del gate, expiración forzada de TTL, revocación de credenciales bajo presión) son la única forma real de saber si el sistema funciona cuando falla algo, no solo cuando todo va bien.
| Métrica | Qué mide | Frecuencia recomendada |
|---|---|---|
| Latencia de aprobación | Tiempo entre solicitud y decisión humana | Continua |
| Tasa de bypass detectado | Intentos de evitar el gate, exitosos o no | Semanal |
| Tiempo medio de mitigación | Desde detección de anomalía hasta contención | Por incidente |
| Éxito de revocación | Porcentaje de credenciales revocadas efectivamente al instante | Mensual |
El informe DORA 2024 encontró que la adopción de IA puede reducir la estabilidad de los despliegues hasta un 7,2 %, precisamente porque muchos equipos tratan estos sistemas con menos rigor de pruebas que al software convencional. La corrección no es frenar la adopción, sino aplicar el mismo estándar de lotes pequeños y pruebas continuas que ya exigen a cualquier otro cambio de producción.
Marcos legales y regulaciones específicas para aprobaciones de despliegue de IA
Las aprobaciones internas de despliegue no viven en el vacío legal, aunque su objetivo sea técnico y no regulatorio. Cuando una empresa opera en sectores con obligaciones de trazabilidad (servicios financieros, salud, infraestructura crítica), el proceso de aprobación interno suele convertirse en la evidencia que un auditor externo o un regulador sectorial exige presentar tras un incidente.
Esto significa que el diseño del registro de auditoría no puede pensarse solo como herramienta de depuración técnica. Debe conservar quién aprobó, con qué parámetros exactos, bajo qué nivel de riesgo declarado y durante cuánto tiempo estuvo vigente esa autorización. Muchos marcos de cumplimiento sectorial (normas de gestión de cambios en entornos regulados, estándares de control interno financiero) ya exigen separación de funciones y ausencia de autoaprobación como requisito, y un sistema de gates bien diseñado satisface esa exigencia como efecto secundario de su propia arquitectura.
La recomendación práctica es tratar cada nivel de aprobación como si tuviera que sobrevivir una auditoría externa, incluso si hoy la empresa no opera en un sector estrictamente regulado. Las obligaciones de trazabilidad tienden a expandirse, no a reducirse, y reconstruir un historial de aprobaciones años después de haberlo diseñado mal es mucho más caro que diseñarlo bien desde el principio. Consulten siempre con su equipo legal o de cumplimiento las obligaciones específicas de su sector antes de fijar los periodos de retención de estos registros.
Criterios éticos para la aprobación de despliegues de IA
Un gate técnico perfecto puede autorizar una acción perfectamente legal y aun así equivocada. La dimensión ética de una aprobación de despliegue no sustituye a los controles técnicos, los complementa en el punto donde el riesgo no es de seguridad sino de impacto en personas reales.
Tres preguntas deberían formar parte de cualquier revisión de nivel 2 o 3: ¿quién queda afectado si esta acción sale mal y no puede revertirse a tiempo?, ¿existe un sesgo conocido en los datos o en el modelo que podría amplificarse en esta acción concreta?, y ¿el aprobador tiene la información suficiente para entender la consecuencia real, o solo ve un resumen técnico sin contexto humano?
La transparencia hacia las personas afectadas por una decisión automatizada, y la posibilidad real de apelarla, son principios que ya aparecen en la mayoría de marcos de gobernanza de IA responsables. Trasladarlos al proceso de aprobación significa, en la práctica, que el diseño del diff que ve el aprobador debe incluir el impacto humano de la acción, no solo su representación técnica. Un aprobador que ve "actualizar registro_cliente" no está en condiciones de evaluar el impacto ético de esa actualización; uno que ve exactamente qué campo cambia y a quién afecta, sí.
Evaluación de riesgos y análisis de impacto previo a la aprobación
Antes de que una acción llegue siquiera al gate de aprobación, necesita pasar por un análisis de impacto que determine si merece llegar a ese nivel o si puede resolverse con controles automáticos más ligeros.
Ese análisis previo combina la probabilidad de fallo con la severidad de sus consecuencias. Una acción con baja probabilidad de error pero consecuencias catastróficas (borrar una base de producción) exige el mismo nivel de escrutinio que una con alta probabilidad de error y consecuencias menores (un correo mal formateado), aunque por razones distintas. El error habitual es evaluar solo la probabilidad y olvidar la severidad, lo que deja pasar acciones raras pero devastadoras sin el control que merecen.
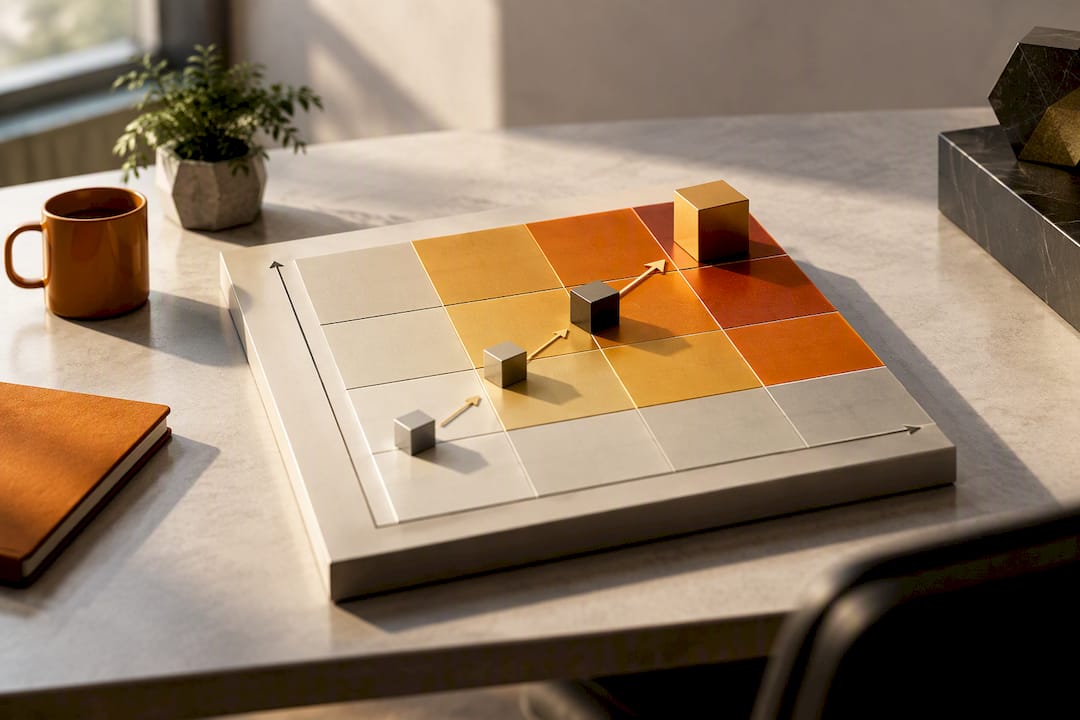
La forma práctica de estructurar esto es una matriz simple: cruzar probabilidad estimada de fallo con severidad del impacto, y usar esa matriz para decidir automáticamente el nivel de aprobación, sin depender del criterio subjetivo de cada revisor en cada caso. Este análisis debe repetirse cada vez que cambie el contexto operativo del agente: nuevas herramientas conectadas, nuevos datos accesibles, o un cambio en el volumen de acciones que ejecuta por hora. Un agente que hace mil llamadas diarias tiene un perfil de riesgo distinto al mismo agente haciendo diez, incluso si la acción individual es idéntica.
Integración con sistemas de gobernanza y cumplimiento normativo
El sistema de aprobaciones no puede ser una isla. Su valor real aparece cuando se conecta con las herramientas de gobernanza que ya usa la organización: gestión de identidades, sistemas de tickets, plataformas de cumplimiento y el propio registro de cambios de infraestructura.
La integración más importante, en la práctica, es la que conecta el gate de aprobación con el sistema de gestión de identidades y accesos (IAM) corporativo. Si un agente pierde acceso a una herramienta porque su credencial expiró o fue revocada, esa señal debe propagarse instantáneamente al PEP/PDP para que ninguna acción pendiente se ejecute con permisos que ya no existen. Sistemas desconectados generan la falsa sensación de control: el dashboard de aprobaciones puede mostrar todo en verde mientras el sistema de identidades ya revocó el acceso hace horas.
La segunda integración crítica es con el sistema de tickets o de gestión de incidentes. Cada aprobación de nivel 3 debería generar automáticamente un registro trazable en ese sistema, no vivir aislada en el panel de la plataforma de agentes. Esto permite que un auditor de cumplimiento, meses después, reconstruya la cadena completa de decisiones sin tener que entrevistar a nadie que ya haya olvidado los detalles. La automatización de esta trazabilidad es, precisamente, uno de los puntos donde plataformas como agent-swarm ayudan a reducir la carga manual sin sacrificar el rigor del registro.
Procedimientos para la revisión y actualización periódica de aprobaciones
Un catálogo de políticas de aprobación que no se revisa se vuelve obsoleto en meses, no en años. Los agentes cambian de herramientas, los modelos se actualizan, y una política escrita para un contexto operativo de hace seis meses puede estar bloqueando acciones seguras o, peor, dejando pasar acciones que ya no deberían ser de bajo riesgo.
La cadencia recomendada tiene tres capas. Una revisión trimestral ligera evalúa si los niveles de riesgo asignados siguen correspondiendo al comportamiento real observado en los logs de auditoría: ¿ese agente que sigue clasificado como nivel 2 lleva seis meses sin un solo incidente y podría bajar de nivel con más automatización, o al revés? Una revisión semestral más profunda revisa los roles y la separación de funciones, comprobando que ningún cambio organizativo haya introducido una brecha de autoaprobación sin que nadie lo notara. Y una revisión inmediata, disparada por cualquier incidente o intento de bypass detectado, ajusta la política afectada antes de que se repita el mismo fallo.
Cada actualización de política debe versionarse igual que el código: con fecha, autor del cambio y justificación registrada, para que el propio historial de políticas sea auditable. Un sistema de aprobaciones maduro trata sus propias reglas con el mismo rigor que exige a las acciones que controla.
Lecciones prácticas sobre confianza y coste operativo
La progresión real de madurez no es binaria; es una escalera de tres escalones: sugerir, donde el agente propone y un humano decide todo; asistir, donde el agente ejecuta lo de bajo riesgo y escala lo demás; y ejecutar, reservado a acciones con historial extenso y reversibilidad probada. Adelantar un flujo de trabajo un escalón antes de tiempo es la causa más común de incidentes evitables.
El coste operativo real de los gates no es la fricción del aprobador: es el diseño de aprobaciones asíncronas con TTL amplio y cachés de decisiones repetidas, que evitan hammering al aprobador sin sacrificar el control donde importa.
Cómo agent-swarm.dev ayuda a implementar aprobaciones de despliegue seguras
agent-swarm es una alternativa al software de agentes que exige confiar ciegamente en su autonomía: al ser código abierto bajo licencia MIT y autohospedable, el control de permisos, las revisiones humanas y el registro de aprobaciones viven en tu propia infraestructura, no en la nube de un tercero que decide qué puedes auditar.
La plataforma incluye control de permisos granular por trabajador, revisiones humanas antes de que una tarea sensible avance, un panel de control centralizado y conectores hacia populares plataformas, para que el gate de aprobación viva donde tu equipo ya trabaja, no en una herramienta separada más. Cada trabajador especializado (Claude Code, Codex, Devin AI, entre otros) opera en un contenedor Docker aislado, lo que reduce el radio de explosión de cualquier fallo antes de que llegue a producción. Pueden revisar cómo funciona esto en sesiones reales documentadas en los ejemplos de agent-swarm, o comparar directamente el enfoque frente a otras arquitecturas en Agent-swarm. Si su equipo necesita este control ya, la versión Cloud comienza con planes de suscripción escalables y pueden revisar los detalles, incluido el modelo Enterprise con despliegue on-premise, en la página de precios.
Fuentes
- Kubernetes — ValidatingAdmissionPolicy
- SAFE-AI / MITRE ATLAS — Framework para asegurar sistemas AI
- Google SRE — Production services protection
Preguntas frecuentes
¿Qué es una aprobación de despliegue IA?
Es el proceso interno que exige revisión y autorización humana antes de que un agente o pipeline de IA ejecute una acción de alto impacto en producción. Combina gates humanos, políticas declarativas y registro de auditoría, siguiendo niveles como los que define OWASP AISVS.
¿Cuándo necesita un agente aprobación humana obligatoria?
Cuando la acción es irreversible, afecta a infraestructura compartida o toca datos regulados. OWASP clasifica esto como nivel 2, con verificación humana obligatoria y un tiempo de vida (TTL) limitado para la autorización.
¿Qué diferencia hay entre un kill-switch y un gate de aprobación?
El kill-switch es un mecanismo de parada aislado y fuera de banda que corta la ejecución en emergencias, mientras el gate de aprobación decide de antemano si una acción específica puede empezar. Ambos son complementarios, no sustitutos.
¿Cómo evita agent-swarm que un agente se salte una aprobación?
Cada trabajador opera en un contenedor Docker aislado con permisos controlados por el equipo, y las revisiones humanas se integran antes de que las tareas sensibles avancen. Los planes y su configuración completa están disponibles en la página de precios.
¿Con qué frecuencia hay que revisar las políticas de aprobación?
Una revisión trimestral ligera basta para la mayoría de los niveles de riesgo, con una revisión semestral más profunda de roles y separación de funciones. Cualquier incidente o intento de bypass debe disparar una revisión inmediata de la política afectada.
Recomendaciones
Related field notes
We Rebuilt Linear's “Loops updates” Clip as a Swarm Video in Eight Rounds
Three video models read Linear's motion-design teaser; the two Gemini models called the 3D scene 2D until 7.5s. A frame-by-frame check caught it. The replica is 858 frames of Remotion and three.js, reviewed eight times.
2–3 vs 5–7 Day Prototypes: AutoGen vs CrewAI for Engineers
Engineer focused comparison of AutoGen and CrewAI with benchmarks (2–3 vs 5–7 engineer days), token and migration checklist, and a 30-job pilot plan.
Trazabilidad de acciones de agentes: qué auditar y cómo
La trazabilidad de acciones de agentes permite auditar y reconstruir eventos con registros íntegros que facilitan cumplimiento y resolución.