Estado compartido entre agentes: la memoria que decide si tu enjambre funciona
Descubre cómo el estado compartido entre agentes ofrece memoria persistente para coordinar enjambres, cuándo usarlo y evitar la contaminación de contexto.
El estado compartido entre agentes es una capa de memoria persistente y gobernada donde varios agentes autónomos leen y escriben contexto para coordinarse en tiempo real. Conviene implementarlo cuando dos o más agentes trabajan de forma concurrente sobre el mismo objetivo y necesitan conservar aprendizajes entre sesiones, no en flujos lineales de un solo agente. El riesgo real no es técnico sino de gobernanza: sin contratos de datos ni control de acceso, la memoria compartida se convierte en una fuente de contaminación de contexto en lugar de una ventaja.
En resumen:
- La memoria compartida entre agentes es persistente y se aloja en bases externas, permitiendo coordinarse en el tiempo y conservar aprendizajes entre sesiones.
- Es fundamental definir scopes y contratos de datos con validación para evitar contaminación del contexto y reducir riesgos de fallos o información incorrecta.
- Los patrones de coordinación incluyen pizarra compartida, registro de eventos y un agente orquestador, usualmente combinados para equilibrar eficiencia y coherencia.
- Antes de desplegar en producción, se recomienda realizar pruebas de concurrencia, inyectar contradicciones y monitorizar latencias y errores para garantizar un funcionamiento fiable.
- Es preferible separar los datos de baja latencia en Redis para facts y locks, del almacenamiento para recall semántico en bases vectoriales, optimizando recursos y rendimiento.
Tabla de contenidos
- Qué es el estado compartido entre agentes y casos de uso operativos
- Patrones arquitectónicos y modelos de visibilidad para diseñar la coordinación entre agentes
- Diseño práctico: contratos de datos, validación y control de conflictos
- Cómo resuelven este problema las implementaciones open-source de referencia
- Checklist operativo para desplegar estado compartido en producción
- Lo que la mayoría de equipos aprende demasiado tarde
- agent-swarm resuelve la gobernanza que este artículo describe, no solo el almacenamiento
- Fuentes
- Preguntas frecuentes
Qué es el estado compartido entre agentes y casos de uso operativos
El estado compartido entre agentes no es lo mismo que la memoria de un solo modelo dentro de su ventana de contexto. La ventana de contexto es efímera: desaparece al cerrar la sesión. El estado compartido es persistente, vive en una base de datos externa y sobrevive a reinicios, caídas y despliegues nuevos. Esa diferencia determina qué agentes pueden coordinarse en el tiempo y cuáles solo ejecutan tareas aisladas sin memoria colectiva.
En arquitecturas maduras conviven varios tipos de artefactos dentro de esa capa:
- Facts: datos verificados que cualquier agente puede consultar sin reinterpretarlos.
- Learnings: conclusiones derivadas de ejecuciones previas, útiles para no repetir errores.
- Locks: marcas temporales que evitan que dos agentes escriban el mismo recurso a la vez.
- Backlogs: colas de trabajo pendiente visibles para todo el equipo de agentes.
- Embeddings: representaciones vectoriales para búsqueda semántica y recall.
La regla práctica es sencilla: si la información debe sobrevivir a la sesión que la generó, o si más de un agente la necesita simultáneamente, pertenece al estado compartido. Si solo sirve para razonar dentro de una tarea puntual, mejor mantenerla aislada.
Patrones arquitectónicos y modelos de visibilidad para diseñar la coordinación entre agentes
La decisión de arquitectura importa más que la elección de base de datos. Antes de escribir una línea de código conviene fijar los scopes, es decir, los niveles de visibilidad que determinan quién puede leer y escribir cada pieza de estado. La jerarquía habitual va de lo más amplio a lo más restringido: global, workflow, sesión y agente individual. Un orden de look jerárquico que consulte primero el scope más específico y solo escale al global cuando no encuentra el dato reduce el ruido en el contexto y baja el coste de tokens en sistemas que combinan recuperación semántica con recall estructurado.
Sobre esa base de scopes se construyen tres patrones de coordinación entre agentes distintos:
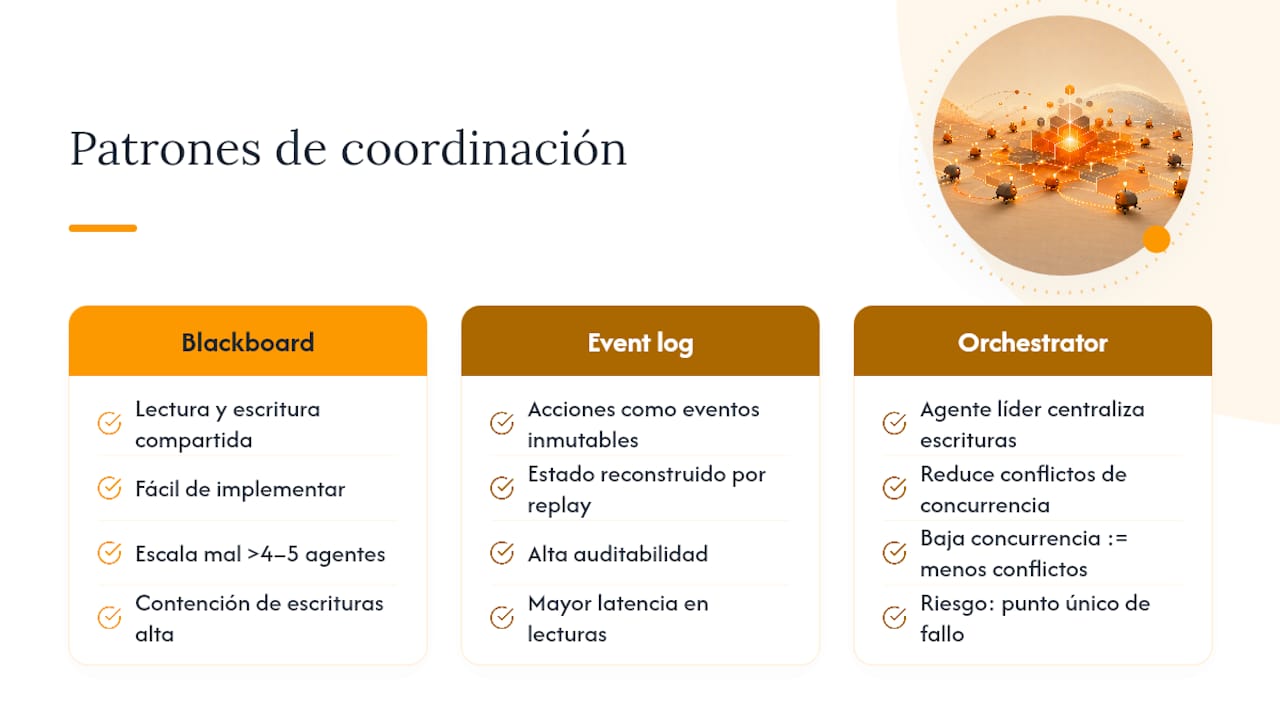
Blackboard: todos los agentes leen y escriben en una pizarra común sin coordinación directa entre ellos. Es el patrón más simple de implementar, pero escala mal cuando hay más de cuatro o cinco agentes activos, porque la contención de escritura crece rápido. 2. Event log: cada acción se registra como un evento inmutable y el estado actual se reconstruye reproduciendo la secuencia. Ofrece auditabilidad total (puedes reproducir cualquier incidente) a cambio de más latencia en lecturas frecuentes. 3. Orchestrator: un agente líder centraliza las decisiones de escritura y delega lecturas a los torques. Reduce los conflictos de concurrencia casi a cero, pero convierte al orquestador en un punto único de fallo si no se replica.
Muchos equipos terminan combinando los tres: blackboard para hechos de bajo riesgo, event log para trazabilidad de decisiones críticas y un orquestador que arbitra escrituras conflictivas. Esta composición híbrida, entre capas scoped y artefactos versionados en almacenamiento externo, aparece de forma recurrente en el análisis de arquitecturas de memoria multiagente como el punto de equilibrio entre eficiencia de tokens y coherencia entre agentes.
Consejo profesional: no metas embeddings ni vectores pesados en el mismo almacén que usas para locks y facts de baja latencia. Sepáralos: Redis o una base clave-valor para estado caliente, una base vectorial dedicada para recall semántico. Mezclarlos convierte cada lectura simple en una consulta cara.
Diseño práctico: contratos de datos, validación y control de conflictos
La diferencia entre un estado compartido fiable y uno que colapsa en producción está en los contratos, no en la infraestructura. La práctica que más reduce fallos es simple: nunca comparta contexto crudo entre agentes. En su lugar, defina un JSON Schema por clave donde cada campo tiene un propietario (ownership) claro y un tipo validado. Esto convierte la capa de memoria en un validador de contratos en lugar de un vertedero de texto libre, un patrón que se repite en implementaciones como memX.
Con los contratos definidos, quedan tres decisiones de diseño ineludibles:
- Resolución de conflictos: last write wins (LWW) funciona para datos de baja criticidad, pero para hechos que varios agentes pueden contradecir conviene un reducer que fusione versiones o un paso de verificación asíncrona antes de aceptar la escritura como definitiva.
- Cristalización periódica: consolidar en lotes las entradas redundantes y suprimir las obsoletas mantiene limpia la superficie de recall en ejecuciones largas, una técnica que MemClaw aplica explícitamente para evitar que memorias contradictorias se acumulen sin control.
- Ciclo de vida explícito: cada entrada debería tener un estado (
active,pending,outdated,archived) y una política de retención asociada, no vivir indefinidamente por defecto.
La auditoría no es opcional. Cada escritura debe registrar agent_id y marca temporal, y el sistema entero se beneficia de tratarse como un event log reproducible en lugar de un valor mutable sin historial. Separar a los agentes que escriben de los que verifican reduce de forma directa la probabilidad de que un dato incorrecto se convierta en una verdad incontestable dentro de la memoria compartida, una lección que MemClaw documenta tras simular semanas de ejecución continua con flotas de agentes.
Cómo resuelven este problema las implementaciones open-source de referencia
Varios proyectos abiertos ya resolvieron piezas concretas de este problema y sus decisiones de diseño son reutilizables aunque no adoptes el proyecto entero.
- memX construye una capa de memoria en tiempo real sobre FastAPI y Redis: expone endpoints
set/get/schema, valida cada escritura contra un esquema por clave, notifica cambios por WebSocket y ofrece un SDK en Python para que cualquier agente se integre sin reinventar el protocolo. - Junto combina MongoDB para persistencia estructurada con ChromaDB para búsqueda vectorial, y añade file locking explícito más un backlog compartido. Su "librarian daemon" enriquece automáticamente entradas antiguas, una forma de mantenimiento continuo poco habitual en proyectos más simples.
- MemClaw y ContextLoom atacan el problema del arranque en frío: cuando un agente nuevo entra a una flota que lleva días operando, necesita "hidratarse" desde una base SQL o NoSQL existente en lugar de empezar con memoria vacía. ContextLoom añade además un hash de ciclo para detectar bucles de comunicación entre agentes antes de que degraden el rendimiento.
Para trasladar estos patrones a un stack empresarial, la pieza que suele faltar es la contenedorización: cada worker corriendo en un contenedor Docker aislado, con acceso controlado a Redis o MongoDB como backend de estado y a una base vectorial para recall semántico, coordinado a través de un protocolo como MCP en lugar de llamadas directas entre agentes.
Checklist operativo para desplegar estado compartido en producción
Antes de pasar a producción, complete estos pasos en orden:
- Defina namespaces y ACL por tenant y por agente. Ningún agente debería tener acceso de escritura global por defecto; las claves API deben limitarse al scope que necesita cada rol.
- Ejecute pruebas de contención de concurrencia. Simule diez o veinte agentes escribiendo sobre la misma clave y mida cuántas escrituras se pierden o se sobrescriben sin control.
- Inyecte contradicciones deliberadas. Fuerce dos agentes a escribir hechos incompatibles y verifique que el mecanismo de reconciliación (reducer o crystallizer) los resuelve sin intervención manual.
- Mida latencia p95 y p99, no solo el promedio. Un backend de estado compartido que funciona bien en promedio pero falla en el percentil 99 bajo carga real generará incidentes silenciosos.
- Practique simulacros de recuperación. Apague el nodo de Redis o MongoDB en un entorno de pruebas y confirme que el sistema restaura desde snapshot sin corromper el estado activo.
Las métricas que conviene vigilar de forma continua son la tasa de errores por escritura, la tasa de contradicciones detectadas y el tiempo medio de recuperación tras un fallo. Operativamente, esto exige snapshots programados, copias de seguridad fuera del clúster principal y un playbook de incidentes escrito antes de que ocurra el primero, no después.
Consejo profesional: documente la política de retención por tipo de artefacto antes del lanzamiento, no después. Un backlog puede vivir semanas; un lock nunca debería sobrevivir más de unos minutos sin liberarse.
Lo que la mayoría de equipos aprende demasiado tarde
El anti-patrón más caro que he visto describir en repositorios y guías de arquitectura es compartir contexto crudo entre agentes sin validación de esquema. El segundo anti-patrón es dar permisos de escritura global a agentes que solo necesitan leer: cada permiso de más es una superficie de fallo que solo se detecta cuando ya causó daño.
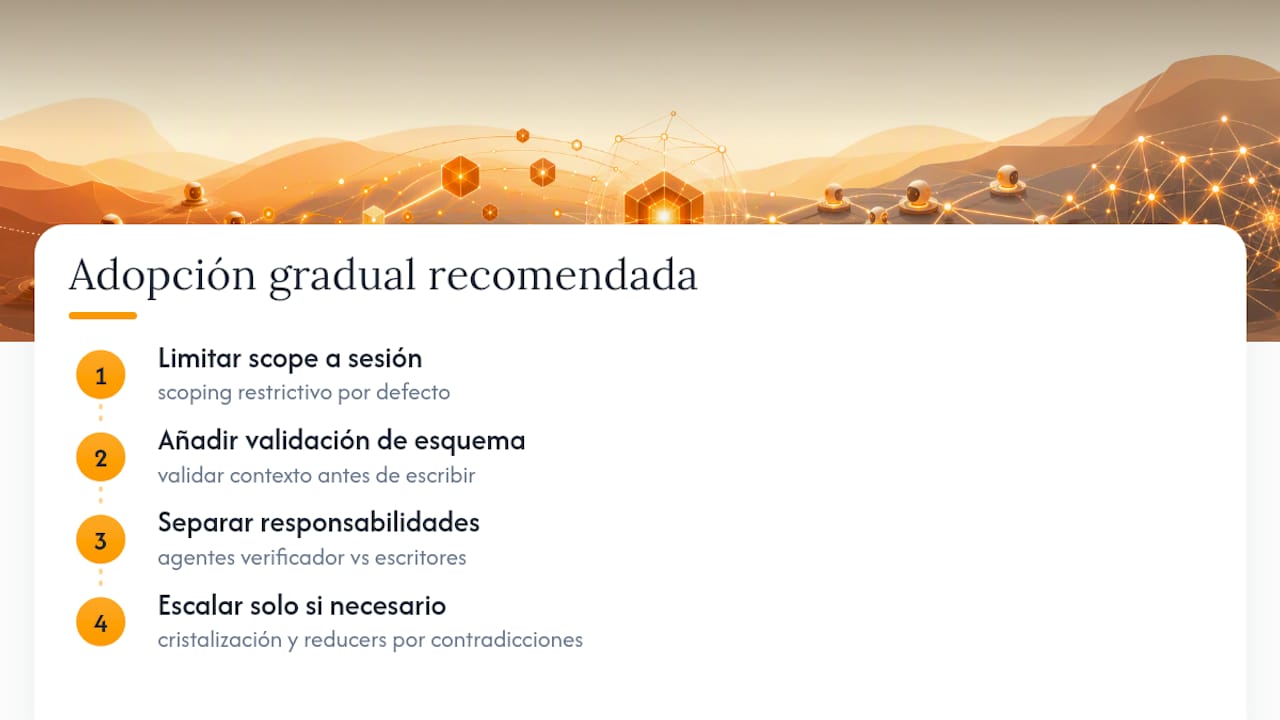
Las prácticas que sí funcionan tienen algo en común: separan responsabilidades con la misma disciplina que aplicaría a un equipo humano. Agentes de verificación independientes de los agentes que escriben, scoping restrictivo por defecto en lugar de acceso amplio "por si acaso", y auditoría por evento en cada escritura. Para equipos que empiezan, la adopción gradual funciona mejor que el rediseño completo: empiece con un scope de sesión simple, añada validación de esquema antes de escalar a más agentes, y solo introduzca cristalización y reducers cuando el volumen de contradicciones lo justifique.
— Ez.-
agent-swarm resuelve la gobernanza que este artículo describe, no solo el almacenamiento
Todo lo anterior (scopes, contratos JSON Schema, ciclo de vida, auditoría por evento) es exactamente lo que agent-swarm construye como sistema operativo para coordinar agentes de IA en tu propia infraestructura. La diferencia frente a plataformas cerradas es que el conocimiento se acumula en tu propio despliegue, con licencia MIT, en lugar de quedar atrapado en un proveedor que restringe qué modelos puedes usar o impide que ese aprendizaje colectivo compuesto se quede en tu empresa.
Un agente líder descompone objetivos en tareas y las asigna a trabajadores especializados (Claude Code, Codex, Devin AI, entre otros) que se ejecutan en contenedores Docker aislados, con estado compartido, permisos y revisiones gestionados de forma centralizada. Las integraciones con Slack, Linear, GitHub y Turso conectan esa capa de memoria con las herramientas donde ya trabaja tu equipo, sin obligarte a migrar procesos existentes. Puede probarse en modalidad self-hosted sin coste según los planes publicados, escalar a Cloud desde 30 hasta 100 € al mes según el número de trabajadores activos, o solicitar una implementación Enterprise con despliegue on-premise. El siguiente paso lógico es revisar los ejemplos de sesiones reales para ver cómo se comporta esa memoria compartida en flujos de trabajo con volumen.
Fuentes
- memX (memx) repository
- Junto memory component
- ContextLoom repository
- AI Agent Memory Architectures for Multi-Agent Systems | Zylos Research
Preguntas frecuentes
¿Qué diferencia hay entre memoria compartida y estado compartido?
La memoria suele referirse al historial acumulado (hechos, aprendizajes, embeddings), mientras que el estado incluye también estructuras operativas transitorias como locks y colas de trabajo. En la práctica ambos términos conviven en la misma capa persistente que consultan los agentes.
¿Qué base de datos conviene para estado compartido entre agentes?
Depende del tipo de dato: Redis funciona bien para estado caliente de baja latencia como locks y facts, mientras que MongoDB o una base vectorial como ChromaDB conviene para persistencia estructurada y recall semántico. Proyectos como Junto combinan ambos enfoques en el mismo despliegue.
¿Cómo se evita la contaminación de contexto entre agentes?
Validando cada escritura contra un esquema JSON Schema con propietario de campo definido, en lugar de compartir texto libre sin estructura. Añadir agentes de verificación independientes de los que escriben reduce además el riesgo de que un dato erróneo se propague sin control.
¿agent-swarm gestiona el estado compartido entre agentes de forma nativa?
Sí, agent-swarm mantiene memoria compartida, historial de contexto y capacidades acumulativas entre el agente líder y sus trabajadores, con control de permisos y revisiones integrados en el propio sistema. Puede desplegarse de forma autohospedada según los planes publicados o contratarse en modalidad Cloud o Enterprise.
¿Qué pasa si dos agentes escriben el mismo dato al mismo tiempo?
Sin una política definida, gana la última escritura (last write wins) y se pierde información silenciosamente. La alternativa más robusta combina un reducer que fusione versiones compatibles con una verificación asíncrona para los casos que realmente son contradictorios.
Recomendaciones
- La memoria de tu agente es un archivo de registro, no una lección: el problema de la memoria prescriptiva
- Tu flujo de trabajo de IA tiene demasiados agentes
- Ajuste adecuado de su enjambre de agentes: lo que realmente indican los gráficos de CPU y RAM del contenedor
- El modelo de decaimiento: cómo desactivamos el envenenamiento de memoria en un enjambre de agentes
Related field notes
Un enjambre de agentes: qué es y cómo se diseña para producción
Descubre qué es un enjambre de agentes y cómo diseñarlo para optimizar tareas complejas, mejorando la eficiencia en producción y análisis.
Orquestación de agentes: guía práctica para equipos de ingeniería
Descubre cómo la orquestación de agentes mejora la eficiencia en flujos de trabajo complejos, integrando múltiples herramientas y aprobaciones. ¡Optimiza...
Pass the 3 AM Test: Airflow Alternatives for Engineering Teams
Compare Airflow alternatives by 3 AM operational ergonomics. Run a two-week POC, test backfill and debugging, and trial agent-swarm for persistent,...