Memoria corporativa con IA: la guía práctica para pymes
Aprende a crear una memoria corporativa con IA que conserva conocimiento, reduce preguntas repetidas, acelera incorporación y agiliza decisiones.
La memoria corporativa con IA es un sistema que captura, estructura y devuelve el conocimiento de una empresa (decisiones, contexto de clientes, procedimientos) de forma persistente entre sesiones, sin depender de que alguien lo recuerde o lo busque manualmente. Para una pyme, el beneficio inmediato es dejar de reconstruir lo que ya se sabía: menos tiempo de onboarding, menos preguntas repetidas y decisiones más rápidas. Funciona combinando captura automática de fuentes dispersas con una entrega contextual de esa información justo cuando se necesita.
En resumen:
- La memoria corporativa con IA combina diferentes tipos de memoria para mantener el conocimiento entre sesiones y usuarios, reduciendo el tiempo de onboarding y preguntas repetidas en pymes.
- La búsqueda semántica permite acceder a la información por intención, facilitando respuestas rápidas en soporte, ventas, o reuniones sin depender de palabras clave exactas.
- La gestión adecuada requiere control de permisos, protección de datos y revisión humana periódica para evitar errores y garantizar la relevancia del conocimiento almacenado.
- Pilotos acotados en áreas con alto volumen documental y consultas frecuentes, como soporte o ventas, permiten obtener resultados medibles antes de ampliar el sistema.
- Implementar en infraestructura propia y definir KPIs claros, como el tiempo de búsqueda y reutilización de contenido, es clave para justificar la inversión en memoria con IA.
Tabla de contenidos
- Por qué las IA estándar olvidan y en qué consiste la memoria persistente
- Cómo se entrega el conocimiento capturado en el día a día
- Beneficios medibles y KPIs que toda pyme debe rastrear
- Riesgos y gobernanza: privacidad, control de datos y memory poisoning
- Hoja de ruta práctica para pymes: del piloto a la implantación
- Casos de uso prácticos aplicables a pymes
- Enfoque práctico del editor: cómo agent-swarm gestiona la memoria compartida entre agentes
- Perspectiva final: cuándo priorizar la memoria corporativa con IA en una pyme
- Cómo empezar con agent-swarm si gestionas conocimiento en una pyme técnica
- Fuentes
- Preguntas frecuentes
Por qué las IA estándar olvidan y en qué consiste la memoria persistente
Un asistente de IA convencional solo «sabe» lo que cabe en su ventana de contexto: el bloque de texto que se le pasa en una conversación concreta. Cuando esa conversación termina, el conocimiento desaparece. Es la razón por la que un chatbot que ayudó a resolver un problema de facturación el lunes no tiene ni idea de qué se habló el martes, aunque sea el mismo cliente y el mismo problema.
La memoria persistente resuelve esa limitación con una arquitectura distinta. En lugar de depender solo del texto que se introduce en cada sesión, guarda representaciones semánticas del conocimiento (decisiones, preferencias, resultados de tareas anteriores) en una base que perdura entre sesiones y entre usuarios. Las investigaciones sobre arquitecturas de memoria en sistemas de IA distinguen varios tipos de memoria (episódica, semántica, procedimental) y muestran cómo su combinación permite conservar decisiones y contexto sin depender de la capacidad limitada de una ventana de contexto.
El coste de no tener esto es real y acumulativo en una pyme:
- Un empleado nuevo tarda semanas en entender por qué un cliente recibe un trato distinto al del manual, porque esa excepción vivía solo en la cabeza de la persona que se fue.
- El equipo de soporte repite preguntas ya resueltas porque el historial de tickets no se conecta con las conversaciones de ventas.
- Un proyecto se retrasa porque nadie recuerda que ya se probó (y descartó) el mismo enfoque hace dos años.
- Cada rotación de personal se lleva conocimiento que nunca quedó documentado en ningún sitio accesible.
Lo que aporta la memoria persistente al flujo de trabajo diario no es solo «guardar más cosas». Es entregar lo relevante en el momento oportuno: cuando alguien abre un ticket, el sistema ya sabe qué se acordó con ese cliente en marzo; cuando alguien empieza en un puesto, el sistema le explica por qué existe tal excepción sin que nadie tenga que redactar un manual perfecto de antemano.
Cómo se entrega el conocimiento capturado en el día a día
Capturar información no sirve de nada si nadie la encuentra cuando la necesita. Aquí es donde la diferencia entre buscar por palabras clave y buscar por significado se vuelve decisiva.
Una búsqueda por palabra clave exige que el usuario adivine el término exacto que se usó al escribir el documento original. Una búsqueda semántica entiende la intención: si alguien pregunta «¿qué le prometimos a este cliente sobre el plazo de entrega?», el sistema encuentra la respuesta aunque el email original nunca use la palabra «plazo».
Sobre esa capa semántica se construyen distintos modos de acceso al conocimiento:
- Copilotos conversacionales que responden preguntas puntuales dentro de una herramienta que el equipo ya usa (Slack, un panel interno, un chat de soporte).
- Agentes que ejecutan acciones, no solo que sugieren respuestas: por ejemplo, actualizar un ticket con el historial relevante sin que nadie tenga que copiarlo a mano.
- Entregas proactivas, donde el sistema empuja información antes de que alguien la pida, en lugar de esperar una consulta.
Un ejemplo operativo típico ocurre en soporte al cliente: cuando llega un ticket nuevo, el sistema identifica al cliente, recupera su historial completo (contratos, tickets anteriores, promesas hechas por ventas) y lo presenta al agente humano en segundos, en lugar de obligarlo a buscar en tres sistemas distintos.
Otro caso frecuente es el de las reuniones. Antes de una llamada con un cliente recurrente, un copiloto con memoria persistente puede resumir automáticamente qué se acordó la última vez, qué quedó pendiente y qué tono conviene usar según el historial de la relación. La misma lógica se aplica a los handovers entre turnos o entre equipos: en lugar de un traspaso verbal incompleto, la persona que recibe el trabajo accede a un resumen estructurado de lo que ya se hizo y por qué.
La gestión del conocimiento basada en IA transforma así información dispersa en algo que se puede accionar directamente dentro de un flujo de trabajo, sin que el usuario tenga que salir de la herramienta donde ya está trabajando.
Beneficios medibles y KPIs que toda pyme debe rastrear
Invertir en memoria corporativa con IA sin medir su impacto es garantizar que nadie recuerde por qué se hizo la inversión al año siguiente. Tres métricas concentran casi todo el valor.
El tiempo de onboarding es la más fácil de justificar ante dirección: cuánto tarda una persona nueva en volverse productiva sin supervisión constante. Se mide comparando el tiempo medio antes y después de implantar el sistema, usando como referencia las últimas cinco o seis incorporaciones previas al piloto.
El tiempo de búsqueda de información es la métrica que más sorprende cuando se mide por primera vez. Basta con pedir a un grupo de empleados que cronometren cuánto tardan en encontrar un dato concreto (una cláusula contractual, una decisión de precios) antes y después del cambio.
La reutilización de contenido mide cuántas veces se recupera y aplica una pieza de conocimiento ya existente en lugar de crearla de cero. Es la métrica que mejor detecta si el sistema realmente se está usando o si quedó como un experimento olvidado.
Dato clave: las estimaciones de sector para 2025 y 2026 apuntan a que gran parte del tiempo de un trabajador del conocimiento se pierde en recrear documentos que ya existían pero no se encontraron, lo que convierte la reutilización de contenido en el indicador más directo del retorno de la inversión.
Para definir una línea base realista, mide estas tres métricas durante dos o tres semanas antes de tocar nada. Después fija objetivos modestos para el primer trimestre (por ejemplo, reducir a la mitad el tiempo de búsqueda en las áreas piloto) en lugar de prometer transformaciones inmediatas que no vas a poder sostener con datos.
Riesgos y gobernanza: privacidad, control de datos y memory poisoning
Una memoria que crece sin control acaba siendo un pasivo, no un activo. Tres frentes de riesgo merecen atención desde el primer día.
El primero es la gobernanza de acceso. No todo el conocimiento debe ser visible para todo el equipo: los datos salariales, los contratos con cláusulas de confidencialidad o las notas internas sobre un cliente conflictivo necesitan permisos granulares, auditoría de quién consultó qué y control de versiones que permita rastrear cuándo cambió una pieza de información y por qué.
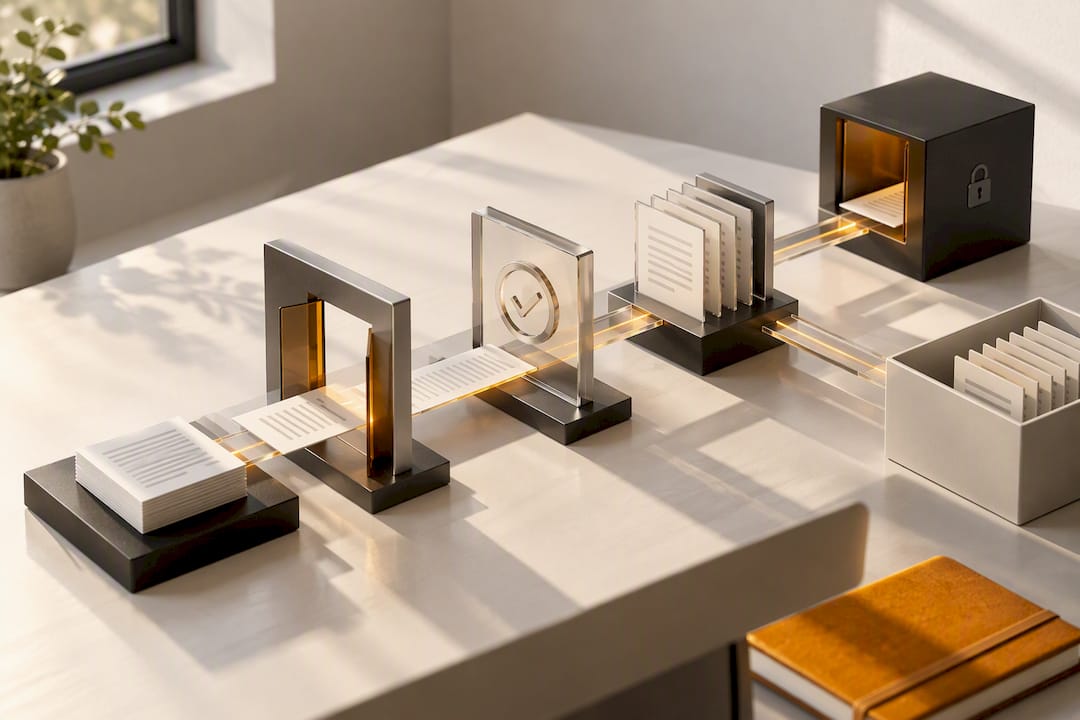
El segundo es la privacidad y la localización de los datos. Cuantas menos veces viaje la información fuera de la infraestructura donde vive, menor es el riesgo de una transferencia no deseada o de un incumplimiento normativo. Esto importa especialmente en sectores regulados, donde alojar la memoria corporativa en un entorno controlado por la propia empresa reduce la superficie de exposición frente a depender de servicios externos con reglas de retención poco claras.
El tercero, más técnico y menos discutido, es el llamado memory poisoning: el riesgo de que información errónea, obsoleta o directamente falsa se cuele en la memoria y se propague como si fuera verdad establecida. Mitigarlo exige varias capas de control:
- Fechas de caducidad para el conocimiento sensible al tiempo (precios, políticas, disponibilidad de producto).
- Revisión humana periódica de las piezas de memoria con mayor impacto en decisiones.
- Modelos de decaimiento que reduzcan gradualmente la confianza en información antigua no revalidada.
- Trazabilidad completa del origen de cada dato, para poder corregir en cascada si una fuente resulta poco fiable.
El debate académico sobre estos riesgos coincide en un punto: la validación humana sigue siendo imprescindible para garantizar que el conocimiento que la IA aprende y propaga sea relevante y exacto, no solo plausible.
Consejo profesional: Trata cada pieza de memoria de alto impacto (una política de precios, un procedimiento legal) como un dato con fecha de caducidad, no como una verdad permanente. Revísala cada trimestre, no cuando algo ya haya salido mal.
Hoja de ruta práctica para pymes: del piloto a la implantación
Implantar memoria corporativa con IA no exige rediseñar toda la infraestructura de golpe. Funciona mejor como un proceso secuencial con puntos de control claros.
- Auditoría de fuentes. Identifica dónde vive el conocimiento crítico hoy (email, CRM, tickets, chats) y cuál de esas fuentes genera más consultas repetidas.
- Piloto acotado. Elige un solo departamento o proceso, no toda la empresa a la vez.
- Medición de KPIs. Aplica desde el primer día las métricas de onboarding, tiempo de búsqueda y reutilización descritas antes.
- Escalado gradual. Solo después de validar el piloto, añade nuevas fuentes y nuevos equipos.
El ámbito recomendado para un primer piloto es de seis a doce semanas, centrado en un área con alto volumen documental y consultas frecuentes: soporte al cliente o ventas suelen ser los mejores candidatos porque generan resultados medibles rápido. Las pymes que empiezan con pilotos acotados en áreas de alto volumen documental obtienen señales de valor mucho antes que quienes intentan cubrir toda la organización desde el principio.
| Elemento del checklist | Qué verificar antes de escalar |
|---|---|
| Permisos | Roles definidos y auditoría de accesos activa |
| Integraciones | Fuentes conectadas sin duplicar datos entre sistemas |
| Formación | Equipo piloto sabe cómo consultar y corregir la memoria |
| Control de calidad | Revisión humana periódica de las respuestas críticas |
Antes de escalar, confirma que cada fila de ese checklist está resuelta, no solo planificada. Escalar sobre una base con permisos mal definidos multiplica el riesgo en lugar de multiplicar el valor.
Casos de uso prácticos aplicables a pymes
La teoría convence menos que ver dónde encaja realmente el conocimiento persistente en el trabajo diario.
- Onboarding acelerado. Un empleado nuevo en el área comercial puede consultar directamente por qué un cliente concreto tiene condiciones especiales, en lugar de esperar a que alguien se lo explique de memoria semanas después.
- Soporte con contexto histórico. Cuando un cliente reabre un caso, el agente ve de inmediato qué se prometió, qué se resolvió y qué quedó pendiente, sin pedirle al cliente que repita su historia.
- Automatización de procesos repetibles. Tareas como validar una solicitud de reembolso o clasificar un ticket según reglas internas pueden ejecutarse con apoyo de agentes que aplican el conocimiento ya capturado, reduciendo el trabajo manual redundante.
- Continuidad ante rotación de personal. Cuando alguien deja la empresa, el conocimiento que generó (decisiones, acuerdos, excepciones) permanece accesible en lugar de irse con la persona.
El punto en común de los cuatro casos es el mismo: el conocimiento deja de vivir solo en la cabeza de alguien y se vuelve consultable por cualquiera que lo necesite, en el momento en que lo necesita.
Enfoque práctico del editor: cómo agent-swarm gestiona la memoria compartida entre agentes
agent-swarm aborda este problema desde la arquitectura de coordinación de trabajo con IA, no solo desde la captura de documentos. El sistema se organiza alrededor de un agente líder que descompone objetivos complejos en tareas concretas y las asigna a trabajadores especializados (Claude Code, Codex, pi-mono, Open Code, Devin AI, entre otros) que operan en contenedores aislados.
Lo relevante para la memoria corporativa es que ese conocimiento no se pierde entre tareas ni entre sesiones. El propio análisis técnico de agent-swarm sobre por qué una memoria prescriptiva vale más que un simple registro de logs explica por qué guardar solo el historial de lo ocurrido no basta: hace falta memoria que componga contexto útil para la siguiente tarea, no solo un archivo de lo que pasó. Ese mismo razonamiento sostiene por qué la memoria procedimental importa más que una base vectorial más grande.
Entre las capacidades que sostienen esto en la práctica:
- Memoria compartida y capacidades acumulativas entre agentes, en lugar de sesiones aisladas que empiezan de cero.
- Integraciones con Slack, Linear, GitHub, Turso y OpenAI, entre cientos de plataformas, para capturar contexto directamente donde ya trabaja el equipo.
- Control de permisos, revisiones y programación de tareas mediante cron, con un panel de control centralizado.
- Despliegue en la infraestructura propia del cliente, lo que mantiene el control sobre dónde vive ese conocimiento.
Los ejemplos reales de sesiones de agent-swarm muestran cómo se aplica esta arquitectura en flujos de trabajo concretos, más allá de la teoría.
Perspectiva final: cuándo priorizar la memoria corporativa con IA en una pyme
No toda pyme necesita esto ya. La señal más clara es la rotación de personal combinada con dispersión de datos: si el conocimiento crítico vive en la cabeza de dos o tres personas y esas personas cambian con frecuencia, cada salida es una fuga de valor que no vuelve a entrar. Si además el volumen de procesos repetibles es alto (soporte, ventas, operaciones), el retorno llega rápido porque cada consulta resuelta sin fricción se acumula.
La recomendación realista es por fases: piloto acotado, medición honesta y expansión solo cuando los números lo justifiquen, no cuando la presión por «usar IA» lo exija. Quien promete transformación total en un trimestre suele estar vendiendo una expectativa, no un resultado.
Y conviene no perder de vista lo que la evidencia académica ya señala: la IA acelera la captura y la entrega de conocimiento, pero la validación humana sigue siendo imprescindible para que ese conocimiento siga siendo correcto con el tiempo. Automatizar sin supervisión no es memoria corporativa. Es simplemente ruido acumulado con buena presentación.
Cómo empezar con agent-swarm si gestionas conocimiento en una pyme técnica
agent-swarm ofrece control total sobre dónde vive tu memoria corporativa, algo que las plataformas cerradas rara vez permiten: al ser código abierto bajo licencia MIT, puedes alojar el sistema y toda la memoria acumulada en tu propia infraestructura, en lugar de depender de un proveedor que decide qué modelo usar y dónde se guardan tus datos.
Existe una versión autohospedada gratuita para siempre, pensada para equipos técnicos que quieren evaluar la arquitectura sin coste inicial.
Un piloto típico empieza con un caso acotado (soporte o un flujo de ingeniería recurrente), conecta las integraciones ya existentes en el equipo (Slack, Linear, GitHub) y deja que la memoria compartida se acumule mientras los agentes trabajan. Consulta los planes y precios para elegir el punto de partida adecuado a tu equipo, o revisa las comparativas frente a otros enfoques si todavía estás decidiendo qué arquitectura se ajusta mejor a tu caso.
Fuentes
Para quien quiera profundizar más allá de esta guía, las investigaciones sobre arquitecturas de memoria en sistemas de IA ofrecen la base académica más sólida sobre tipos de memoria y su combinación en sistemas agentivos. La guía de gestión del conocimiento basada en IA cubre con más detalle la integración multifuente y la conexión con flujos operativos.
Sobre gobernanza y mitigación de riesgos, el análisis técnico de agent-swarm sobre memory poisoning y modelos de decaimiento y la guía práctica de validación humana en sistemas de IA son buenos puntos de partida para diseñar controles concretos antes de escalar cualquier piloto.
- Artículo académico sobre dilemas éticos y estratégicos de IA
- arXiv: investigaciones sobre arquitecturas de memoria en IA
- Gestión del conocimiento basada en IA: guía 2026 (Automation Anywhere)
- Celiveo: documentos imprescindibles para la memoria corporativa con IA (2026)
Preguntas frecuentes
¿Qué IA tiene la mejor memoria persistente?
No existe una IA única con «la mejor» memoria: depende de la arquitectura, no del modelo de lenguaje en sí. Los sistemas que combinan memoria semántica, episódica y procedimental, como describen las investigaciones sobre arquitecturas de memoria en IA, superan a cualquier asistente que solo dependa de una ventana de contexto amplia.
¿Qué es una IA corporativa?
Una IA corporativa es un sistema de inteligencia artificial diseñado para operar sobre el conocimiento y los procesos específicos de una empresa, en lugar de responder solo con conocimiento genérico. Suele integrarse con las herramientas internas (CRM, email, documentos) para dar respuestas basadas en el contexto real de esa organización.
¿Cuál es la mejor IA para empresas que quieren gestionar conocimiento?
La opción más adecuada depende del tamaño del equipo y de si se necesita control total sobre dónde viven los datos. Para pymes técnicas que priorizan gobernanza propia e integración con herramientas como Slack, Linear o GitHub, un sistema open source como agent-swarm permite mantener la memoria compartida en infraestructura propia en lugar de depender de un proveedor cerrado.
¿Qué es la memoria corporativa y en qué se diferencia de un simple archivo?
La memoria corporativa es el conjunto de conocimiento acumulado por una empresa (decisiones, procedimientos, relaciones con clientes) organizado para ser consultado y reutilizado, no solo almacenado. A diferencia de un archivo estático, una memoria corporativa con IA se actualiza, se estructura semánticamente y se entrega de forma proactiva cuando el contexto lo requiere.
¿Cuánto cuesta implantar memoria corporativa con IA en una pyme?
El coste varía según si se opta por autoalojar el sistema o usar una versión gestionada en la nube. agent-swarm, por ejemplo, ofrece una versión self-hosted sin coste de licencia y una versión Cloud desde 30 hasta 100 € al mes según el número de agentes activos, con precios detallados en su página de planes.
Recomendaciones
- IA con intervención humana: una guía práctica
- La memoria de tu agente es un archivo de registro, no una lección: el problema de la memoria prescriptiva
- Envenenamiento de memoria: por qué la memoria persistente del agente es una bomba de tiempo
- Automatización de flujos de trabajo agenticos: una guía de ingeniería práctica
Related field notes
Automatizar Linear con agent-swarm.dev y IA: seguridad para ingenieros
Implementa automatizaciones agentivas en Linear con agent-swarm.dev. Diseña flujos con confirmación humana, canary releases y auditoría para evitar...
Engineers, Avoid the 3 AM Pager With These Camunda Alternatives
Engineer focused Camunda alternatives for durable, agentic workflows. Compare Temporal, Step Functions, Airflow, Inngest, and agent-swarm.
Propiedad de datos IA: qué exige la ley al entrenar modelos
Saber qué exige la ley sobre la propiedad de datos en IA: documentar orígenes y base legal, evaluar impacto y cumplir el RGPD al entrenar.