El standup diario con IA: cómo automatizarlo sin perder el control
Automatiza el standup diario con IA: extrae GitHub, Jira y calendario, redacta la actualización y la deja lista para envío tras revisión humana.
Sí: puedes automatizar el borrador y la entrega del standup diario con agentes de IA. El sistema extrae datos de GitHub, Jira y el calendario, redacta la actualización y la publica en Slack o Notion. La condición no negociable es la revisión humana antes de enviar, porque el objetivo real es liberar tiempo para discutir bloqueos, no eliminar el criterio del equipo.
En resumen:
- La automatización del borrador de standup con IA requiere configurar permisos específicos y ajustar la ventana de revisión entre 24 y 72 horas según las zonas horarias y ritmo del equipo.
- Es fundamental que todo borrador generado pase por una revisión humana antes de ser publicado para evitar errores y mantener el criterio del equipo.
- La integración con plataformas como GitHub y Jira, combinada con modelos de lenguaje, puede reducir el tiempo de preparación diaria de minutos a segundos.
- Personalizar los umbrales de bloqueo y el vocabulario según el proyecto y roles específicos ayuda a evitar alertas falsas y mejorar la relevancia del informe.
- La plataforma agent-swarm.dev facilita la gestión del pipeline completo, soporta integración amplia y permite mantener la memoria del equipo, siendo compatible tanto para autoalojamiento como en la nube.
Tabla de contenidos
- Qué incluye un standup diario con IA y por qué funciona
- Pasos técnicos imprescindibles para ponerlo en marcha
- Reglas del equipo para que la automatización no falle
- Flujo y prompts de ejemplo: de la ventana de datos a la entrega
- Por qué agent-swarm.dev es una base sólida para esta automatización
- Cómo personalizar la IA para adaptarse a tu equipo y proyecto
- Casos de uso y resultados que ya se están viendo
- Errores comunes al implementar IA en el standup diario
- Reflexión crítica: los límites de automatizar el standup
- Cómo empezar con agent-swarm.dev
- Fuentes
- Preguntas frecuentes
Qué incluye un standup diario con IA y por qué funciona
Un standup diario IA bien construido no inventa información: la reorganiza. El agente lee las fuentes donde ya vive el trabajo del equipo (control de versiones, gestor de tickets, calendario y pipeline de integración continua) y convierte esos datos dispersos en una actualización legible en segundos.
Las fuentes típicas son cuatro:
- Pull requests y commits: qué se abrió, fusionó o quedó pendiente de revisión desde el último corte.
- Tickets de Jira o Linear: cambios de estado, movimientos de columna, nuevas asignaciones.
- Calendario del equipo: reuniones, vacaciones o bloqueos de tiempo que explican una ausencia de actividad.
- Resultados de CI/CD: builds rotos, tests fallidos o despliegues bloqueados.
El agente extrae identificadores concretos (número de PR, clave de ticket, hash de commit) y los referencia directamente en el borrador, en lugar de generar prosa genérica. El formato ideal responde a las tres preguntas clásicas del standup con frases cortas de una o dos líneas, cada una con su enlace o ID. Esto reemplaza la recitación mecánica de «ayer hice esto, hoy haré esto», que consume minutos sin aportar valor, y deja el tiempo de la reunión para lo que sí importa: decidir cómo resolver un bloqueo.
Pasos técnicos imprescindibles para ponerlo en marcha
Configurar un sistema de standups asistido por IA exige orden en cinco frentes: acceso a datos, ventana temporal, programación, pipeline de generación y almacenamiento.
- Autenticación y permisos. Crea tokens con alcance mínimo para GitHub, Jira, Notion o Slack: lectura de repositorios y tickets, escritura solo en el canal de destino. Evita tokens de administrador cuando el agente solo necesita leer actividad.
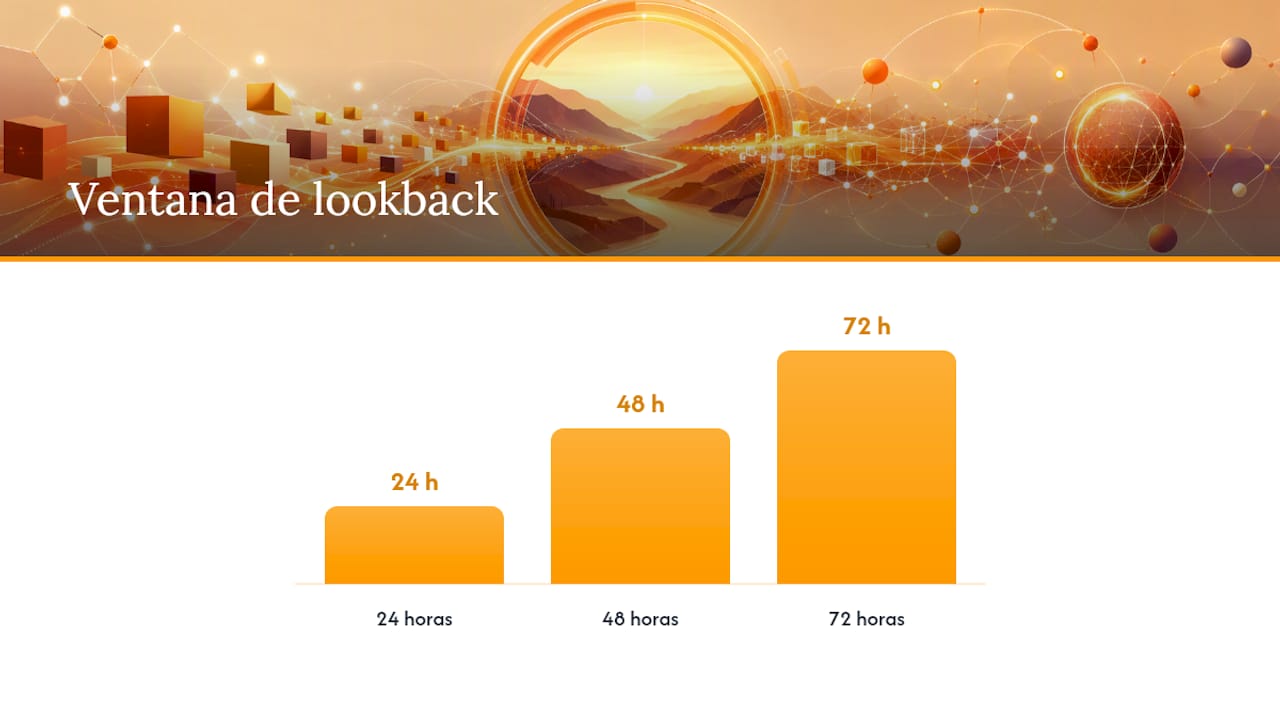
- Ventana de lookback. Decide si el agente mira las últimas 24, 48 o 72 horas. Un equipo con sprints cortos y alta cadencia de commits funciona bien con 24 horas; equipos distribuidos en varias zonas horarias suelen necesitar 48 horas para no perder actividad del fin de la jornada anterior.
- Programación del job. Configura un cron en Linux o un job de launchd en macOS que dispare la extracción unos minutos antes de la hora del standup, con margen para revisión humana previa al envío.
- Pipeline de generación. El flujo estándar es extracción de datos, análisis con un modelo de lenguaje, redacción del borrador, revisión humana y entrega final. Cada etapa debe poder auditarse por separado si algo sale mal.
- Exportación y archivo. Guarda cada standup generado en Markdown, HTML o PDF con fecha en el nombre del archivo. Esto crea un historial buscable útil para retrospectivas y auditorías de proceso, tal como practican los agentes de planificación con modo headless y exportación.
Consejo profesional: Empieza con un lookback de 48 horas incluso si tu sprint es diario. Es más fácil acortar la ventana después de ver falsos positivos que ampliarla tras perder contexto real de un bloqueo.
Una arquitectura habitual cruza GitHub y Jira, pasa los datos por un modelo de lenguaje para el análisis y publica el resultado donde el equipo trabaja. Bien implementada, esta cadena puede reducir una tarea de 40 minutos a apenas 2 por ciclo.
Reglas del equipo para que la automatización no falle
La parte técnica es la mitad del trabajo. La otra mitad son las normas que el equipo acuerda para que el borrador generado sea útil y no ruido.
- Escribe para quien está dormido. Un ingeniero en otra zona horaria debe entender el bloqueo sin necesitar contexto adicional. Cada frase debe incluir el «qué» y el «por qué», nunca solo el «qué».
- Trata los bloqueos como peticiones, no como quejas. Cada bloqueo detectado o reportado debe llevar un responsable propuesto y un plazo razonable, igual que una petición formal de ayuda.
- Nunca envíes sin revisión humana. El asistente redacta un primer borrador; una persona lo aprueba o lo edita antes de publicarlo. Tratar al sistema como un compañero junior que entrega un borrador, no como una autoridad final, evita que errores de interpretación lleguen al canal del equipo.
- Adapta la cadencia a las zonas horarias. Publicar la actualización a la hora local de cada persona, o mediante hilos asíncronos, respeta a los equipos remotos mejor que forzar un corte único de horario.
Consejo profesional: Reserva el standup síncrono en vivo para semanas de alta complejidad: un incidente en producción, un lanzamiento crítico o una decisión de arquitectura. El borrador automatizado no sustituye la conversación cuando el riesgo es alto.
Los equipos que migran a este modelo asíncrono con canal dedicado y respuestas en hilos reportan mejor visibilidad y trazabilidad del trabajo frente al modelo puramente verbal.
Flujo y prompts de ejemplo: de la ventana de datos a la entrega
Un flujo reproducible tiene cuatro piezas: el prompt de generación, los umbrales de detección, el comando programado y la política de archivo.
- Prompt por pregunta. Pide al modelo tres bloques separados: «¿Qué hiciste ayer? (1-2 frases, con IDs de PR o ticket)», «¿Qué harás hoy? (mismo formato)» y «¿Tienes bloqueos? (responsable sugerido y plazo)». Diseñar el prompt así, pregunta por pregunta, evita que el modelo derive hacia prosa larga y mantiene el borrador enfocado en datos verificables.
- Umbrales de bloqueo. Marca como bloqueo cualquier PR sin revisión pasadas 48 horas, o cualquier ticket sin movimiento pasadas 72 horas. Ajustar estos umbrales según la duración del sprint evita alertas falsas sobre trabajo que simplemente avanza despacio por diseño.
- Comando programado. Un job de cron o launchd ejecuta el script en modo headless para extracción silenciosa, o en modo interactivo cuando se necesita confirmación humana antes de publicar. Esta distinción entre ejecución headless e interactiva es habitual en los agentes de planificación de scrum diseñados para este caso de uso.
- Exportación con fecha. Cada ejecución se guarda como archivo Markdown o HTML con la fecha en el nombre, formando un historial que sirve tanto para auditoría como para detectar patrones de bloqueo recurrentes.
Con este pipeline bien calibrado, un borrador automatizado reduce el tiempo de preparación diaria a apenas unos 30 segundos de revisión por persona, frente a los varios minutos que exige redactarlo a mano cada mañana.
Por qué agent-swarm.dev es una base sólida para esta automatización
Construir este pipeline desde cero (autenticación, extracción, generación y entrega) es exactamente el tipo de flujo recurrente que un sistema de orquestación de agentes debería absorber en lugar de que cada equipo lo reinvente con scripts sueltos.
agent-swarm.dev es un sistema operativo de código abierto donde un agente principal descompone un objetivo (por ejemplo, «genera y entrega el standup diario») en tareas y las asigna a trabajadores especializados que corren en contenedores aislados. Sus rasgos más relevantes para este caso de uso:
- Integraciones amplias: soporte nativo para Slack, Linear, GitHub, Turso y OpenAI, entre cientos de plataformas, cubriendo justo las fuentes que un standup automatizado necesita leer.
- Memoria compartida persistente: el contexto de sprints anteriores, decisiones y bloqueos recurrentes se acumula en lugar de perderse cada día, algo que un script aislado no ofrece.
- Programación de tareas integrada: permite definir jobs recurrentes sin depender de scripts externos de cron gestionados manualmente.
- Revisión previa al envío: el panel de control permite aprobar o editar antes de publicar, alineado con la regla de que ningún borrador sale sin ojos humanos.
- Tres modelos de despliegue: self-hosted, Cloud y Enterprise, según si el equipo prioriza control total de infraestructura o rapidez de puesta en marcha.
Cómo personalizar la IA para adaptarse a tu equipo y proyecto
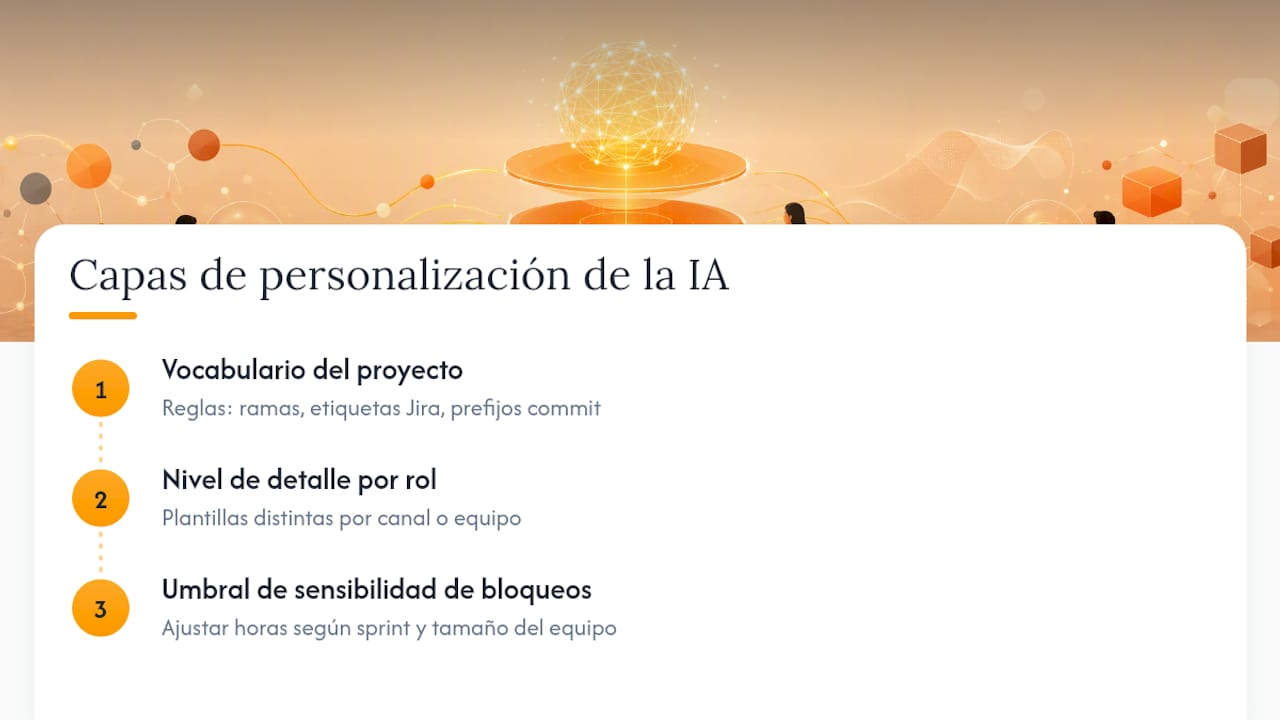
La configuración por defecto rara vez encaja con la realidad de un equipo concreto. La personalización real ocurre en tres capas.
La primera es el vocabulario del proyecto. Si el equipo usa convenciones propias para nombrar ramas, etiquetas de Jira o prefijos de commit, el agente necesita esas reglas explícitas en su configuración inicial, no genéricas. Un equipo que etiqueta bloqueos con blocked: en Jira debe indicárselo al sistema para que los detecte sin ambigüedad.
La segunda capa es el nivel de detalle por rol. Un equipo de backend puede necesitar referencias a esquemas de base de datos y latencia de endpoints; un equipo de producto necesita menos jerga técnica y más contexto de impacto en usuarios. Configurar plantillas distintas por canal o por equipo evita que todos reciban el mismo formato genérico.
La tercera es el umbral de sensibilidad ante bloqueos, que ya depende del ritmo de cada proyecto: un equipo en fase de mantenimiento puede tolerar 72 horas sin movimiento en un ticket, mientras que un equipo en sprint de lanzamiento crítico debería marcar alerta a las 24 horas. Ajustar estos umbrales según la duración del sprint y el tamaño del equipo, en lugar de dejar el valor por defecto, reduce las alertas falsas que hacen que el equipo empiece a ignorar el sistema.
La memoria persistente ayuda aquí: cuanto más contexto acumula el sistema sobre patrones normales del equipo, mejor distingue una pausa habitual de un bloqueo real.
Casos de uso y resultados que ya se están viendo
El patrón más común de adopción no es sustituir la reunión, sino sustituir la preparación de la reunión. Equipos que cruzan GitHub y Jira a través de un modelo de lenguaje reportan que tareas que antes tomaban 40 minutos de recopilación manual bajan a unos 2 minutos una vez el pipeline está calibrado.
Otro patrón de uso real aparece en equipos completamente distribuidos que abandonan la reunión síncrona diaria. Al moverse a un canal dedicado con mensajes programados y respuestas en hilos, consiguen mejor visibilidad del estado de cada persona sin forzar a nadie a conectarse fuera de su horario razonable, según documenta el caso de standups asíncronos de Copera.
Un tercer caso de uso, menos comentado, es el archivo histórico como herramienta de retrospectiva. Cuando cada standup se exporta y se guarda con fecha, el equipo puede revisar semanas después con qué frecuencia un mismo ticket apareció como bloqueo, o cuántos días tardó un PR concreto en recibir revisión. Esa trazabilidad, casi accidental al principio, termina siendo tan valiosa como el ahorro de tiempo diario.
Errores comunes al implementar IA en el standup diario
El error más frecuente es automatizar el envío sin revisión. Un equipo entusiasmado activa el pipeline completo, incluida la publicación automática, y descubre días después que el agente interpretó mal un estado de Jira o citó un PR cerrado como abierto. La solución es simple: el envío final siempre pasa por una persona, sin excepción, incluso cuando el sistema lleva semanas funcionando bien.
El segundo error es fijar un lookback demasiado corto. Una ventana de 24 horas parece razonable hasta que un fin de semana o una zona horaria distinta hace que el agente reporte falta de actividad cuando en realidad el trabajo ocurrió fuera de esa ventana. Ampliar a 48 horas suele resolverlo sin generar ruido adicional.
El tercer error es dar por hecho que el formato por defecto sirve para todos los roles. Un borrador pensado para ingeniería resulta ilegible para un responsable de producto que solo necesita saber si algo se retrasa. Personalizar la plantilla por audiencia evita que la gente empiece a ignorar el mensaje.
El cuarto error, más sutil, es tratar el borrador de IA como una fuente de verdad en vez de un primer intento. El asistente actúa mejor como colaborador junior que redacta, no como sistema autoritativo que decide. Mantener esa jerarquía de responsabilidad es lo que separa una automatización útil de una fuente de errores silenciosos.
Reflexión crítica: los límites de automatizar el standup
Automatizar el borrador no significa automatizar el juicio. El mayor riesgo no es técnico: es dejar de revisar porque el sistema «casi siempre acierta». Controla los alcances de los tokens para no exponer datos privados de clientes o código sensible, y reserva el formato síncrono para decisiones de alta complejidad donde la cultura de equipo y el matiz humano todavía pesan más que cualquier borrador generado.
Cómo empezar con agent-swarm.dev
Si ya identificaste qué fuentes necesitas conectar y qué reglas quieres imponer, el siguiente paso lógico es no construir el pipeline desde cero. agent-swarm.dev ofrece código abierto bajo licencia MIT: puedes autohospedarlo de forma gratuita y mantener la memoria del equipo dentro de tu propia infraestructura, con control total sobre privacidad y gobernanza, en lugar de depender de un servicio cerrado que decide por ti qué modelo usar.
Para equipos que prefieren empezar sin gestionar servidores, la versión Cloud tiene un coste de entre 30 y 100 € al mes según el número de trabajadores activos, visible en la página de precios. Los equipos con necesidades de integración a medida y despliegue on-premise pueden optar por el plan Enterprise, con condiciones bajo contrato. Puedes revisar sesiones reales de agentes en acción antes de decidir, o comparar directamente las diferencias entre mantener un agente propio frente a un equipo alojado. El primer paso razonable es probar la versión self-hosted con un solo flujo, el del standup diario, y expandir desde ahí.
Fuentes
Para replicar los comandos y prompts mencionados, el repositorio de agentes de planificación scrum en GitHub ofrece código funcional con modos headless e interactivo listo para adaptar.
- Redacta automáticamente tu daily standup a partir de PRs de GitHub y actividad de Jira
- Cómo nuestro equipo hace standups asíncronos por completo dentro de Copera – Copera Blog
- Automatiza tu daily standup con IA — de 40 minutos a 2 con un solo comando | Calidad sin Humo
- omardin14/scrum-planning-ai-agent
Preguntas frecuentes
¿Qué es exactamente un standup diario con IA?
Es un sistema que extrae datos de GitHub, Jira y el calendario del equipo, redacta un borrador de la actualización diaria y la entrega en el canal habitual, como Slack o Notion. El agente sustituye la recopilación manual, no la decisión de qué hacer con los bloqueos.
¿Puede la IA detectar bloqueos automáticamente?
Sí, mediante umbrales configurables: por ejemplo, marca como bloqueo un PR sin revisión pasadas 48 horas o un ticket sin movimiento pasadas 72 horas. Ajustar estos umbrales según el ritmo del sprint evita falsas alarmas que erosionan la confianza en el sistema.
¿Sustituye la IA la reunión de standup en vivo?
No debería. La automatización elimina la recitación de estados para liberar tiempo, pero las decisiones complejas y los incidentes críticos siguen necesitando conversación síncrona y criterio humano directo.
¿Cuánto tiempo ahorra realmente automatizar el standup?
Los borradores automatizados pueden reducir la preparación diaria a unos 30 segundos de revisión por persona, frente a varios minutos de redacción manual, siempre que alguien revise el borrador antes de enviarlo.
¿Cuánto cuesta implementar algo así con agent-swarm.dev?
La versión self-hosted de agent-swarm.dev se puede usar de forma gratuita bajo licencia MIT. La versión Cloud cuesta entre 30 y 100 € al mes según el número de agentes activos, según la página de precios, y el plan Enterprise se cotiza a medida.
Recomendaciones
Related field notes
6 Approval Workflow Features That Prove agent-swarm.dev Fits Engineers
Why agent-swarm.dev suits engineering teams: AI enabled orchestration, persistent workflow memory, and self-hosted or cloud deployment. Learn how to...
Estado compartido entre agentes: la memoria que decide si tu enjambre funciona
Descubre cómo el estado compartido entre agentes ofrece memoria persistente para coordinar enjambres, cuándo usarlo y evitar la contaminación de contexto.
Pass the 3 AM Test: Airflow Alternatives for Engineering Teams
Compare Airflow alternatives by 3 AM operational ergonomics. Run a two-week POC, test backfill and debugging, and trial agent-swarm for persistent,...